Gemini 4 Hydrogen vs Argon: ¿qué tareas asignar a cada uno?
Guía de rutas para producción con Gemini 4 Hydrogen y Gemini 4 Argon: cargas de trabajo, coste completo, señales de escalado y límites de las alternativas.
 EvoLink TeamEquipo de producto
En este artículo
Aquí no se presentan resultados controlados de cargas Hydrogen frente a Argon. Las capacidades de referencia provienen de la documentación del proveedor; la política, los ejemplos y las fórmulas orientan el diseño de aplicaciones.
En la guía de selección de Google, Hydrogen es un candidato para programación cotidiana, documentos multimodales y ejecución en paralelo; Argon se orienta a tareas avanzadas de largo alcance. Es el posicionamiento del proveedor, no un reparto medido de tu tráfico. Por ejemplo, un servicio de mantenimiento de repositorios puede evaluar cambios rutinarios respaldados por pruebas en una ruta y análisis de fallos entre módulos en otra, con la misma revisión y controles de aceptación. Adopta cada asignación solo si la respaldan los resultados.
Gemini 4 Hydrogen vs Argon: capacidades y límites compartidos
| Variable de selección | Referencia de Hydrogen en el proveedor | Referencia de Argon en el proveedor | Qué comprobar en EvoLink |
|---|---|---|---|
| Contexto compartido | 1,048,576 tokens entre entrada, razonamiento y salida | Mismo diseño de ventana compartida | Límites del protocolo y espacio restante para la respuesta |
| Salida larga | Long decode más allá de un tramo síncrono | Long decode compatible | Continuación nativa; no deducir compatibilidad del protocolo OpenAI |
| Razonamiento | low, medium, high, xhigh; high predeterminado | low, medium, high; medium predeterminado en la comparación de Google | Valores compatibles y selección explícita |
| Tramo sin streaming | Google documenta hasta 65,536 | Google compara un límite REST por tramo de 32,768 | Contrato real de la pasarela y comportamiento del SDK |
| Herramientas y salida estructurada | Capacidades compatibles | Capacidades compatibles | Esquemas, firmas de razonamiento, errores y ejecución de herramientas |
| Precios | Modelo y calendario comercial propios | Modelo y calendario comercial propios | Tarifa actual de la cuenta, incluidas caché y herramientas |
xhigh hasta que lo confirme la documentación de la ruta. Del mismo modo, una diferencia en el límite REST de Google no prueba que tu pasarela implemente silenciosamente esa misma diferencia.No conviertas los modelos en una historia especulativa sobre arquitectura. «Argon destilado» no queda demostrado por una escala de precios, el nombre de un elemento o respuestas parecidas. Operativamente importan la interfaz compatible y la calidad del trabajo aceptado bajo tu configuración.
Elige la ruta según el coste del fallo de la tarea
Empieza por el contrato de salida y las consecuencias de un error. Un modelo puede ser un buen primer candidato para una tarea sin ser la ruta más segura para una variante de mayor impacto. Registra las clases por separado para que un promedio no esconda un fallo crítico.
| Carga de trabajo | Política de evaluación inicial | Prueba de aceptación | Cuándo no basta la política inicial |
|---|---|---|---|
| Extracción documental de campos fijos | Probar Hydrogen frente a la ruta actual | Campos obligatorios, valores exactos, unidades y evidencia de origen | Fallan campos críticos o no puede resolverse la ambigüedad |
| Mantenimiento de repositorios | Comparar ambos con tareas reproducibles | Pruebas correctas, cambio dentro del alcance y revisión asumible | Persisten fallos difíciles y Argon demuestra que los resuelve |
| Agente de herramientas de varios pasos | Empezar por la ruta que ya cumple y probar la otra | Herramientas autorizadas completan la operación y la respuesta refleja sus resultados | Solicitudes válidas fallan repetidamente pese a herramientas fiables |
| Informe largo o especificación generada | Comprobar contexto y continuación antes de elegir por modelo | Secciones completas, referencias válidas y salida reanudable | El cliente no reanuda correctamente o falta evidencia |
| Juicio de gran impacto sin referencia automática | Exigir un proceso de revisión documentado | Criterios revisados por personas y controles de error crítico | Ninguno aporta la evidencia o autoridad necesarias |
En extracción, no se trata de si Argon parece más cuidadoso, sino de si corrige un fallo concreto frente a una referencia. En programación, comprueba si arregla el comportamiento sin otra regresión. En un agente, distingue error de modelo de fallo del servicio de herramientas: cambiar de modelo no restaura una base de datos caída ni concede un permiso ausente.
Un papel como «ejecutor» o «verificador» es una asignación propuesta por la aplicación, no un nivel de capacidad garantizado por el nombre. Evalúa también al verificador. Dos modelos pueden coincidir en una respuesta sin respaldo; el acuerdo no es una fuente independiente de verdad.
Decide entre ruta directa y escalado
Hay tres políticas iniciales útiles. Compáralas sobre la misma población de tareas entrantes y con la misma definición de trabajo aceptado.
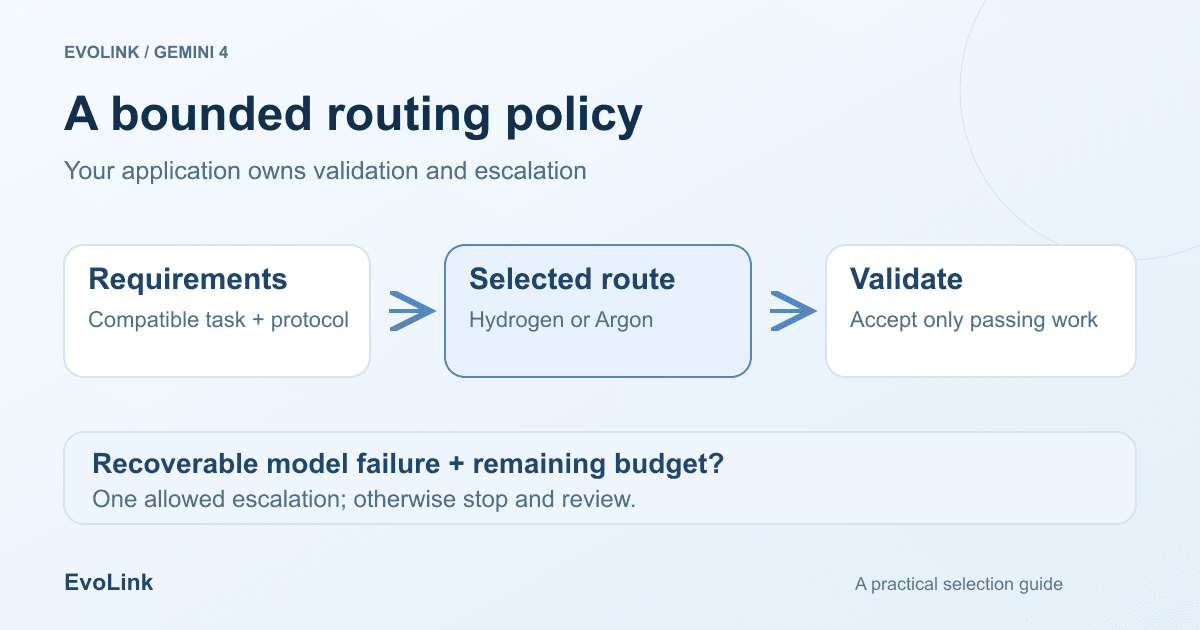
Un árbol de decisión práctico sigue este orden:
- Comprueba requisitos obligatorios. ¿El protocolo acepta la entrada, expone la herramienta y admite el flujo de salida requerido? Descarta rutas incompatibles antes de comparar calidad.
- Usa resultados evaluados por clase de tarea. Elige la ruta directa que cumpla calidad, latencia y coste de esa clase. Si falta evidencia, haz una evaluación acotada en vez de inferir un ganador.
- Valida la respuesta. Aplica controles de esquema, ejecución, evidencia y autorización. Acepta solo lo que cumpla los requisitos de la tarea.
- Clasifica el fallo. Falta de evidencia, herramientas no disponibles, permiso denegado, datos mal formados y un fallo real de razonamiento necesitan respuestas distintas.
- Escala solo un fallo de modelo recuperable. Lleva la evidencia original pertinente y los resultados de validación, comprueba presupuesto y tiempo restantes y realiza el segundo intento permitido.
- Detente en el límite de la política. Si falla el segundo intento, devuelve un estado explícito de incompleto o pendiente de revisión. No alternes modelos hasta que uno dé una respuesta convincente.
Son recomendaciones de orquestación en la aplicación. No describen una función incorporada de EvoLink que evalúe respuestas automáticamente o envíe cada fallo a un modelo mejor.
Calcula toda la ruta, incluido el trabajo que falla
Para una política de escalado, define:
c_H: coste total medio de API/herramientas de la etapa Hydrogen por tarea entrante, incluidos los reintentos permitidos en esa etapa;r: proporción de todas las tareas entrantes que llegan realmente a Argon;c_A: coste completo medio de API/herramientas de la etapa Argon por tarea escalada;a: proporción de tareas originales que termina cumpliendo los criterios comunes de aceptación.
Entonces:
Coste medio API/herramientas por tarea entrante = c_H + r × c_ACoste API/herramientas por tarea aceptada = (c_H + r × c_A) / aLa segunda expresión no está definida si a es cero. Si incluyes tiempo de revisión, añade explícitamente su coste esperado en vez de presentar el gasto API como todo el coste empresarial. La población y los criterios deben ser iguales en todas las políticas.
Incluye la validación facturable basada en modelos en la etapa que la invoca. Si otro modelo o servicio juzga la respuesta fuera de esas etapas, añade su coste esperado al numerador antes de dividir por la aceptación. Informa por separado de la ejecución local de pruebas u otros costes de infraestructura cuando queden fuera de tu definición de gasto API/herramientas.
| Política | Gasto total API/herramientas | Tareas originales aceptadas | Coste API/herramientas por tarea aceptada |
|---|---|---|---|
| Solo Hydrogen | $6 | 800 | $0.0075 |
| Solo Argon | $12 | 960 | $0.0125 |
| Hydrogen y luego Argon para 200 tareas a $0.012 cada una | $8.40 | 950 | Aproximadamente $0.00884 |
En la tercera fila, $6 + 200 × $0.012 = $8.40. Si Hydrogen aceptó 800 tareas originales, el total de 950 implica que 150 de las 200 escaladas añadieron una tarea aceptada. Son hipótesis ilustrativas, no tasas observadas, precios de modelos ni una promesa de ahorro. Los resultados de cada política se suponen por separado, no constituyen una prueba determinista emparejada: el escalado puede usar comentarios de validación y otro contexto de solicitud. Mide su éxito y c_A en el subconjunto escalado real en vez de deducirlos del promedio de Argon directo. Este ejemplo supone validación local sin una tarifa API adicional de modelo; añade cualquier coste de validador facturable como se indica arriba.
La política puede dejar de resultar atractiva enseguida. Si escalan demasiadas tareas, la primera etapa añade coste antes de la ruta que habrías usado de todos modos. Si el validador no detecta respuestas erróneas, la aceptación informada engaña. Si rechaza respuestas correctas, el escalado innecesario gasta tiempo y dinero. Valida al validador con referencias etiquetadas por personas o ejecutables.
La latencia también cambia. Una tarea escalada pasa secuencialmente por primera etapa, validación y segunda etapa. No promedies dos valores p95 medidos de forma independiente para llamarlos el p95 de la ruta. Mide la finalización de extremo a extremo de la política real y separa las tareas escaladas para que una mayoría rápida no esconda una cola lenta de fallos.
Define señales de escalado auditables
Una señal útil se vincula al incumplimiento de un requisito. Una autoevaluación vaga como «no estoy seguro» puede ser una característica para inspeccionar, pero no una autorización de gasto ilimitado.
| Señal | Primera acción | Cuándo tiene sentido otro modelo | Condición de parada |
|---|---|---|---|
| Falla un esquema o tipo requerido | Comprobar corrección de la solicitud/esquema | La solicitud válida sigue sin resolverse y la alternativa superó esta clase de fallos en evaluación | Un escalado permitido o el presupuesto de tarea |
| Falla una prueba ejecutable | Conservar la salida y el contexto original pertinente | Es plausible una corrección del modelo y es seguro intentarla | Siguen fallando pruebas o se amplía el alcance |
| Cita sin respaldo | Comprobar que la fuente contiene la respuesta | Otra interpretación solo sirve cuando existe evidencia | Falta evidencia: pedirla o revisar |
| Timeout de herramienta | Aplicar la política de reintentos del servicio | Cambiar de modelo no arregla la disponibilidad | Se alcanza timeout o plazo límite |
| Autorización denegada | Respetar la denegación | Nunca usar otro modelo para eludir permisos | Detener la operación no autorizada |
| El contexto no cabe | Reducir o recuperar evidencia pertinente, o cambiar el flujo | Solo si la otra ruta tiene realmente una capacidad compatible | Ninguna ruta admite el contexto de forma segura |
Por ejemplo, si un script de migración generado falla una prueba reproducible, puedes llevar ese fallo a un intento con Argon. Una respuesta de herramienta «permission denied» no debe provocar lo mismo. Una firma ilegible en un PDF no se vuelve evidencia fiable porque otro modelo adivine el mismo nombre.
Evita escrituras repetidas al escalar. Si el primer intento pudo haber ejecutado ya una operación, concilia su estado antes de reintentar. Conserva identificadores de idempotencia y deja los efectos secundarios bajo responsabilidad de la capa de ejecución. Elegir modelo no elimina los límites de transacción de la aplicación.
Conserva el estado sin asumir portabilidad entre modelos
previous_interaction_id, un token de continuación nativo o un objeto de estado serán aceptados por un endpoint de pasarela no relacionado.Para un escalado gestionado por la aplicación, construye la siguiente solicitud con la evidencia original aprobada y una descripción explícita del fallo. No presentes las conclusiones sin respaldo de un modelo fallido como verdad de referencia. Si no está documentada la transferencia de estado, inicia una solicitud nueva compatible y contabiliza la entrada repetida; ocultar ese coste distorsiona la comparación.
Nombra y versiona las configuraciones. El destino de una reversión debe incluir modelo, razonamiento compatible, versión de prompt, esquema y política de herramientas. Así evitas volver al modelo dejando un ajuste que la alternativa no acepta.
Prueba la política antes de hacerla predeterminada
Evalúa ambas rutas directas antes de la cascada. Si no, no sabrás si la capa adicional de enrutamiento mejora algo. Congela un conjunto etiquetado con tareas ordinarias, difíciles y fallos conocidos; prueba Hydrogen directo, Argon directo y el escalado propuesto. Registra todos los intentos bajo el ID original de tarea.
Inspecciona los desacuerdos entre modelos y validador. Revisa errores críticos aunque mejore el coste medio. El control de aceptación también debe ser suficientemente independiente para detectar respuestas expresadas con seguridad pero incorrectas; un verificador que repite la explicación inicial no es un control sólido.
Después, ejecuta una política en sombra aprobada y sin efectos secundarios. Confirma distribución real de entradas, gestión del estado, frecuencia efectiva de escalado y uso completo. Luego usa un despliegue canario limitado con umbrales escritos de fallos críticos, coste por tarea aceptada, tiempo de finalización y acciones de herramientas. Conserva una alternativa directa inmediata y una persona que pueda desactivar la política.
No fuerces todas las solicitudes a pasar por la cascada. Las clases difíciles conocidas pueden salir más baratas y rápidas en una ruta directa. Las sencillas que ya pasan quizá no necesiten otro modelo. Sin pruebas de aceptación fiables, la revisión manual o un resultado claramente incompleto pueden ser más seguros que otro intento automático.
Preguntas frecuentes
¿Toda tarea debe empezar por Hydrogen porque sus tokens cuestan menos?
No. Prueba coste completo del ciclo y resultados. Una tarea que casi siempre escala puede funcionar mejor en su ruta directa ya validada.
¿Hydrogen es una versión destilada de Argon?
Este artículo no tiene evidencia primaria que establezca esa arquitectura. Usa la identidad documentada y el comportamiento compatible en vez de deducir el entrenamiento a partir del posicionamiento.
¿Argon siempre da una respuesta mejor?
Aquí no se establece ese resultado universal. Compara ambos con una referencia específica de la tarea, incluidos casos difíciles y errores críticos.
¿La salida larga justifica elegir Argon en vez de Hydrogen?
Ambos modelos documentan long decode. Comprueba contexto compartido, límites por tramo y continuación del protocolo; no conviertas una capacidad común en una ventaja exclusiva de Argon.
¿Cuándo debo escalar a Argon?
Cuando persiste un fallo de modelo detectable y recuperable, la evaluación muestra que la alternativa ayuda en esa clase y aún queda tiempo y presupuesto. Falta de permisos o de evidencia necesita otra respuesta.
¿El segundo modelo puede verificar automáticamente al primero?
Puede participar en un flujo de revisión propuesto, pero el acuerdo no demuestra corrección. Evalúa al verificador y usa pruebas ejecutables, fuentes o revisión humana donde sea necesario.
¿Puedo reutilizar conversación, caché y continuación entre modelos?
Solo donde lo documente el protocolo elegido. Conserva correctamente el historial requerido, no traslades tokens específicos a ciegas y contabiliza la entrada repetida al crear una solicitud nueva.
¿Cuándo debe dejar de reintentar el flujo?
Al llegar al límite escrito de intentos, tiempo o gasto, o cuando otra llamada no pueda corregir el fallo. Devuelve un estado claro de revisión o incompleto en vez de un ciclo interminable de cambios de modelo.
Fuentes y límites de la evidencia
- Especificaciones de Google Hydrogen.
- Especificaciones de Google Argon.
- Guía de migración entre modelos de Google Hydrogen.
- Precios de Google Gemini API.
- Referencia de la API nativa Gemini de EvoLink.
Comprobado el 12 de noviembre de 2026. Las especificaciones son propias de cada canal. La asignación de cargas, las reglas de ruta y el ejemplo de 1,000 tareas son diseños propuestos, no un benchmark publicado ni una descripción de enrutamiento automático de EvoLink.