Gemini 4 Carbon vs Claude Fable 5.2: código, razonamiento y coste por tarea
Elige Carbon o Fable 5.2 con pruebas de repositorios, niveles CursorBench y coste total, y organiza el trabajo entre modelos mediante EvoLink.
 EvoLink TeamEquipo de producto
En este artículo
Dos conjuntos de resultados apoyan ese punto de partida: Carbon obtiene una puntuación cercana a Fable max en el CursorBench actual con un coste publicado inferior; Fable destaca en las evaluaciones de ingeniería sobre repositorios publicadas por Anthropic. Las ventajas cambian con la tarea y el nivel de razonamiento, por lo que conviene definir el ámbito de cada modelo.
Elige Carbon o Fable según la tarea
| Tu tarea | Primera opción para probar | Criterio para mantenerla |
|---|---|---|
| Cambios complejos en varios archivos controlando el gasto | Carbon medium | Pruebas superadas, cambios aceptables y tarea completa dentro del presupuesto |
| Migraciones entre módulos o errores difíciles con mucha recuperación manual | Fable 5.2 | Menos enfoques descartados, omisiones y tiempo de investigación |
| Procesos de negocio que utilizan varias herramientas | Evaluar Carbon y compararlo con el modelo actual | Orden de acciones, parámetros y estado final del negocio correctos |
| Trabajo diario fiable con dificultades ocasionales | Mantener el principal y añadir una ruta de escalado | El escalado resuelve un bloqueo real del proceso actual |
| Revisar código generado por otro modelo | Elegir otro modelo para una revisión independiente | Hallazgos reproducibles, regresión superada y falsos positivos controlables |
La tabla propone el orden de una primera evaluación. Los menores precios base de Carbon sirven para establecer una referencia de presupuesto; los resultados de Fable en repositorios justifican probarlo pronto en trabajos con un alto coste de fallo. Elige el revisor teniendo en cuenta el modelo de implementación, para que creación y comprobación no dependan totalmente del mismo criterio.
Imagina una refactorización de pagos que debe mantener la idempotencia y el comportamiento histórico de los reintentos. Lo importante es que el modelo reconozca las restricciones de la interfaz antigua, proponga una migración verificable y complete las pruebas de regresión. Si un mejor plan evita horas de trabajo repetido, el precio por token pesa menos en la decisión.
¿Qué dicen los benchmarks de programación?
Fable puntúa más alto en algunas evaluaciones de repositorios
La tabla de lanzamiento de Fable 5.2 publicada por Anthropic incluye estas pruebas compartidas:
| Tarea evaluada | Gemini 4 Carbon | Claude Fable 5.2 |
|---|---|---|
| FrontierSWE v2: ingeniería de software en repositorios | 61.2% | 69.9% |
| FrontierCode 2.0: cambios de código que cumplen el criterio de integración | 41.1%, medium | 49.1%, xhigh |
| AutomationBench: flujos de negocio | 53.9% | 51.4% |
| OSWorld 2.1: subconjunto de escritorio sin conexión, puntuación parcial | 81.5% | 89.3% |
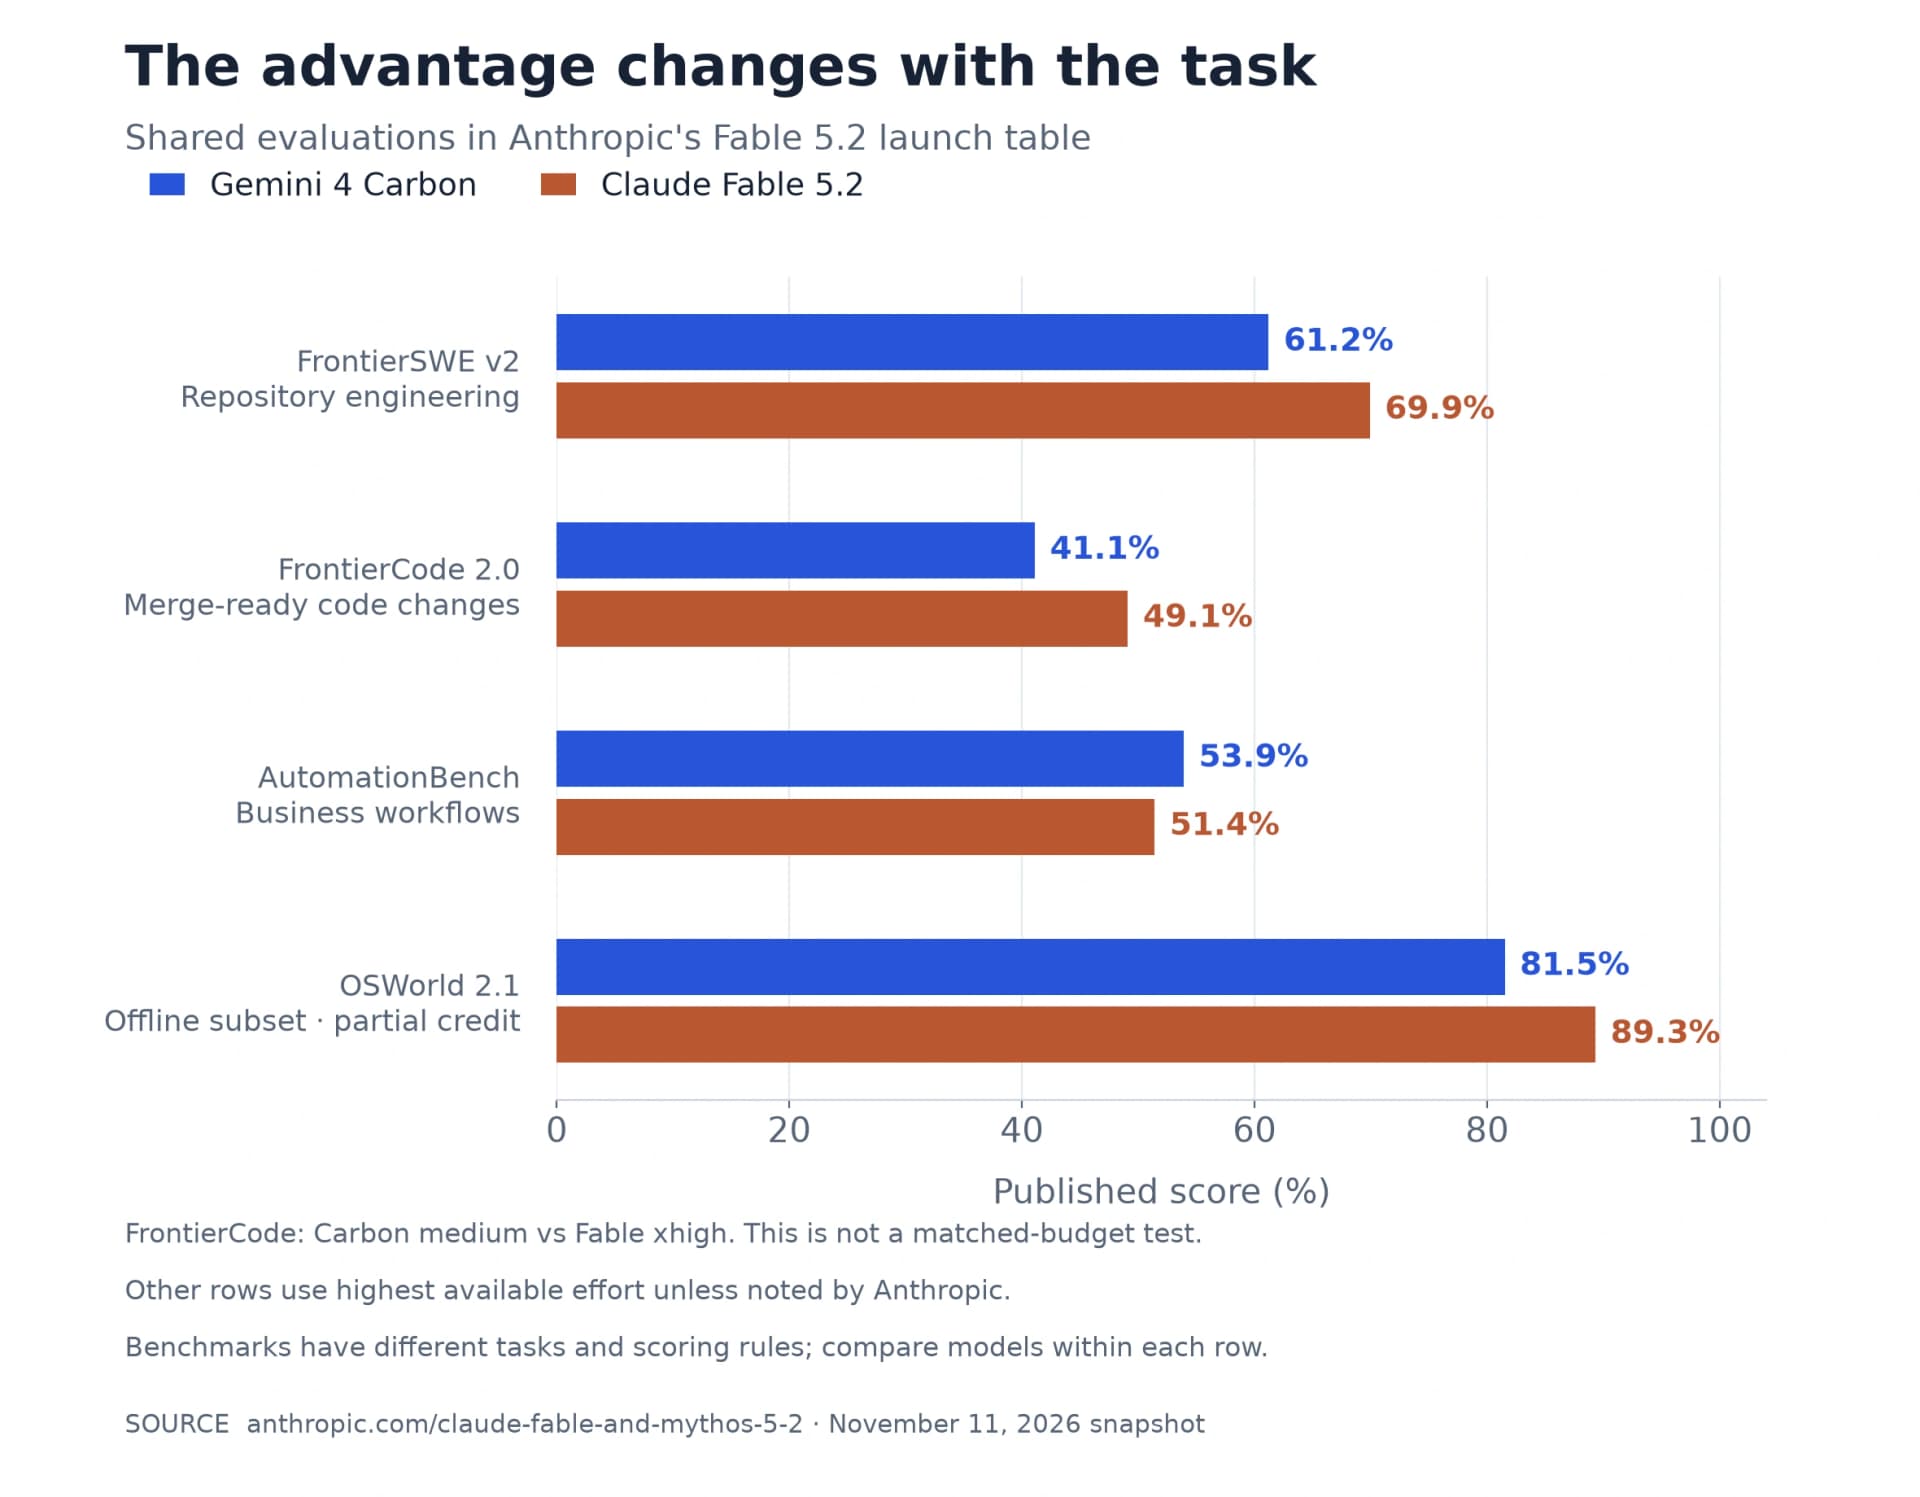
Esto apoya probar Fable primero en modificaciones difíciles de repositorios y da una razón para evaluar Carbon en flujos de negocio. Las operaciones de escritorio, el código y la automatización empresarial tienen criterios de finalización distintos. Relaciona cada resultado con el trabajo que debes entregar.
Carbon ofrece una configuración atractiva para altas exigencias en CursorBench
CursorBench 4.0 utiliza tareas ambiguas de varios archivos procedentes de sesiones reales de Cursor. Estas son algunas configuraciones consultadas el 11 de noviembre:
| Configuración | Puntuación | Coste medio publicado por tarea |
|---|---|---|
| Carbon high | 60.4% | $9.22 |
| Carbon medium | 60.1% | $8.49 |
| Carbon low | 58.6% | $11.89 |
| Fable 5.2 max | 60.0% | $32.79 |
| Fable 5.2 high | 56.9% | $9.70 |
| Fable 5.2 medium | 54.8% | $4.66 |
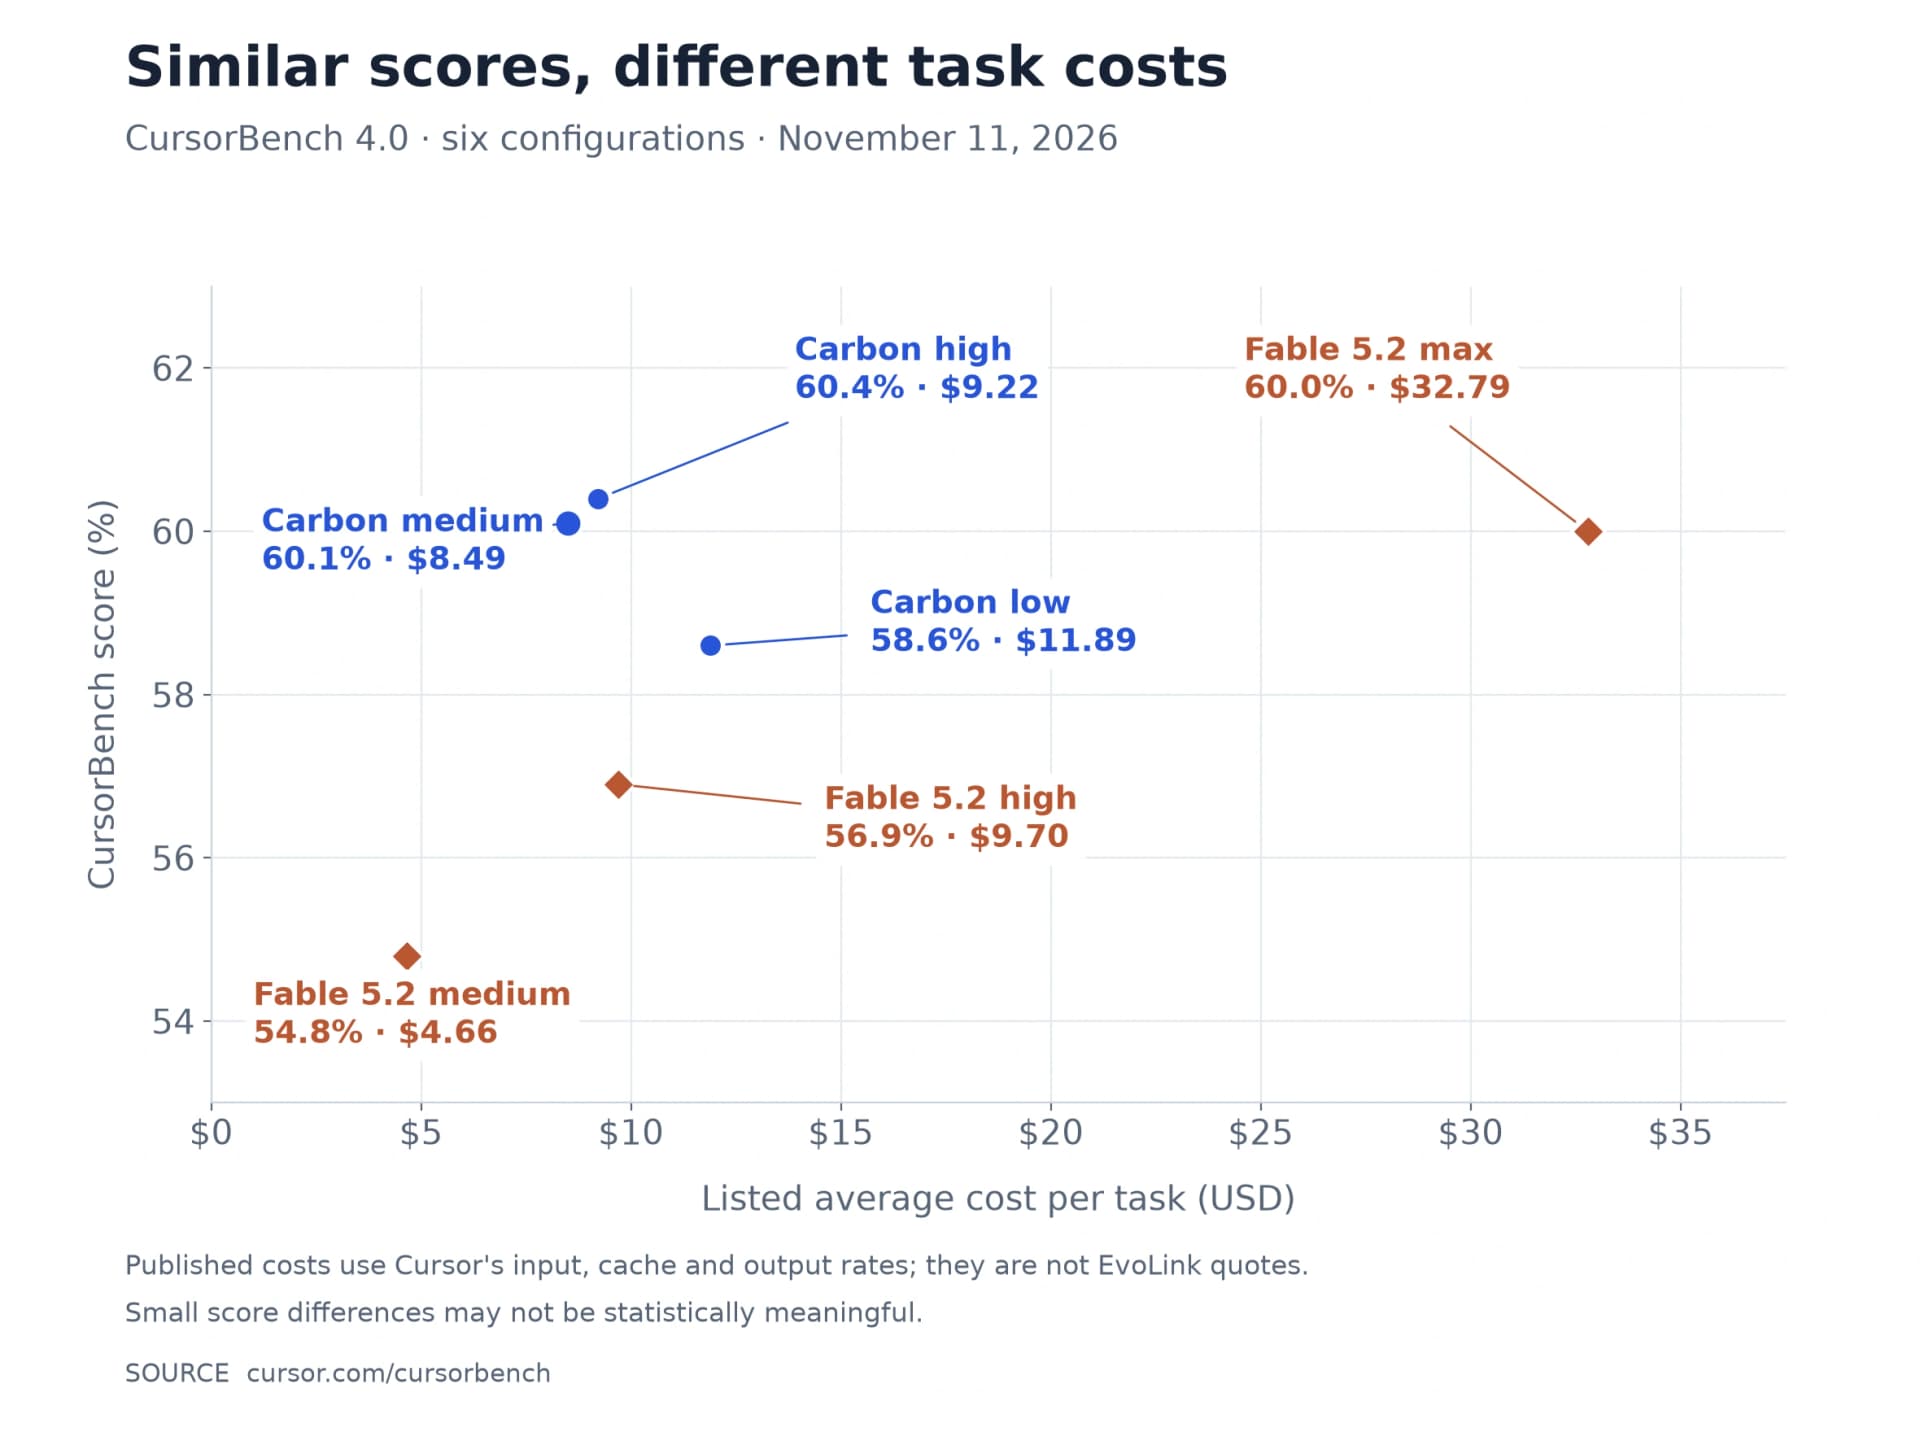
Carbon medium se acerca a Fable max con un coste publicado bastante inferior, por lo que merece ser un primer candidato para código complejo. Fable medium cuesta menos en estas tareas y también puntúa menos. Si esa calidad cumple tus requisitos, el nivel inferior de Fable también puede encajar.
El coste medio de Carbon low supera al de medium. En un agente de varios pasos, reducir el razonamiento de cada turno puede cambiar la ruta de ejecución y el consumo total. Elige el esfuerzo según la finalización y la factura completa.
¿Cuándo merece la pena pagar el mayor precio de Fable?
Estas son las tarifas base Standard de los proveedores, en dólares estadounidenses por millón de tokens. Excluyen caché, Batch, modo rápido y herramientas de pago adicionales.
| Modelo y periodo de facturación | Entrada | Salida |
|---|---|---|
| Carbon, hasta el 30 de noviembre de 2026 inclusive | $2 | $10 |
| Carbon, desde el 1 de diciembre de 2026 | $4 | $20 |
| Fable 5.2 | $8 | $40 |
- Carbon durante el lanzamiento: $0.30.
- Carbon a tarifa regular: $0.60.
- Fable 5.2: $1.20.
En tareas reales pueden variar la tokenización, el razonamiento, las herramientas y los reintentos. Fable se justifica si reduce fallos, reescrituras manuales o tiempo de investigación en una clase de tareas. Carbon se justifica si cumple los mismos criterios de aceptación con un menor coste total.
Comparar programación creativa mediante proyectos públicos
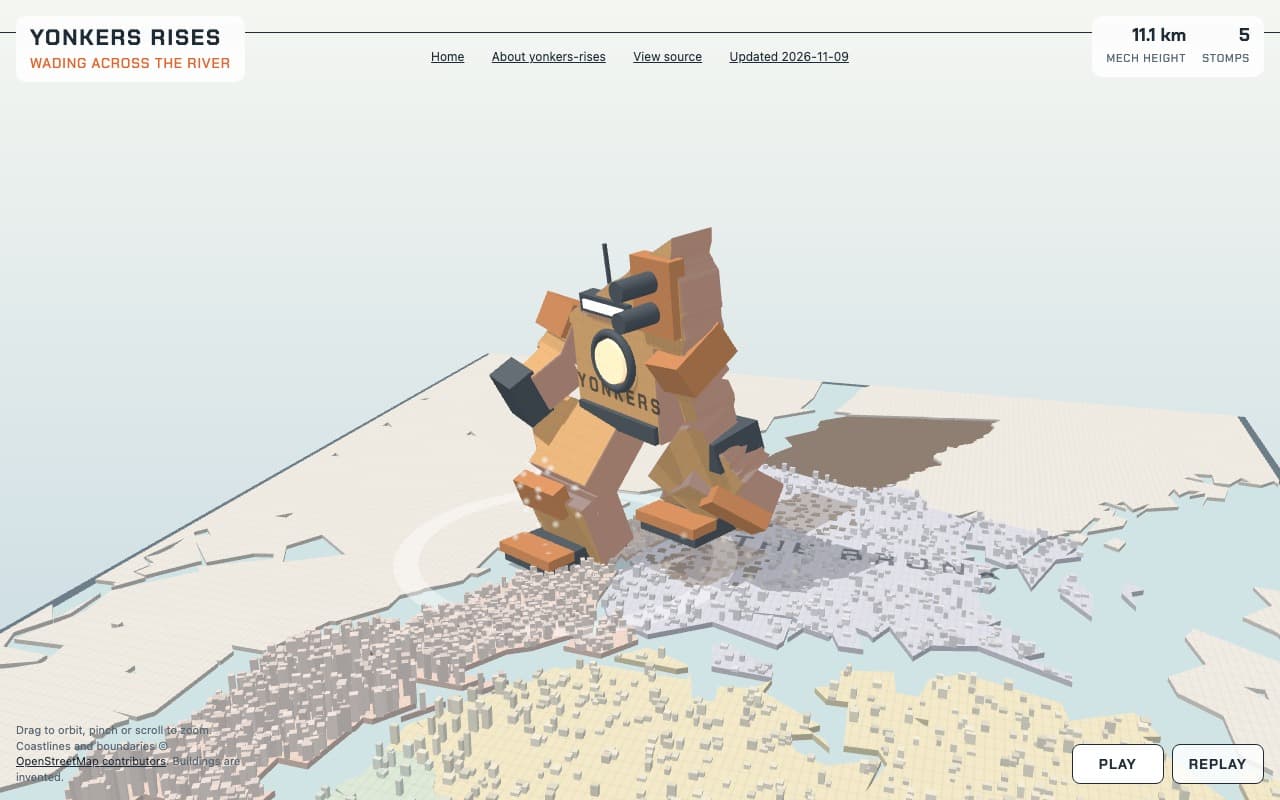
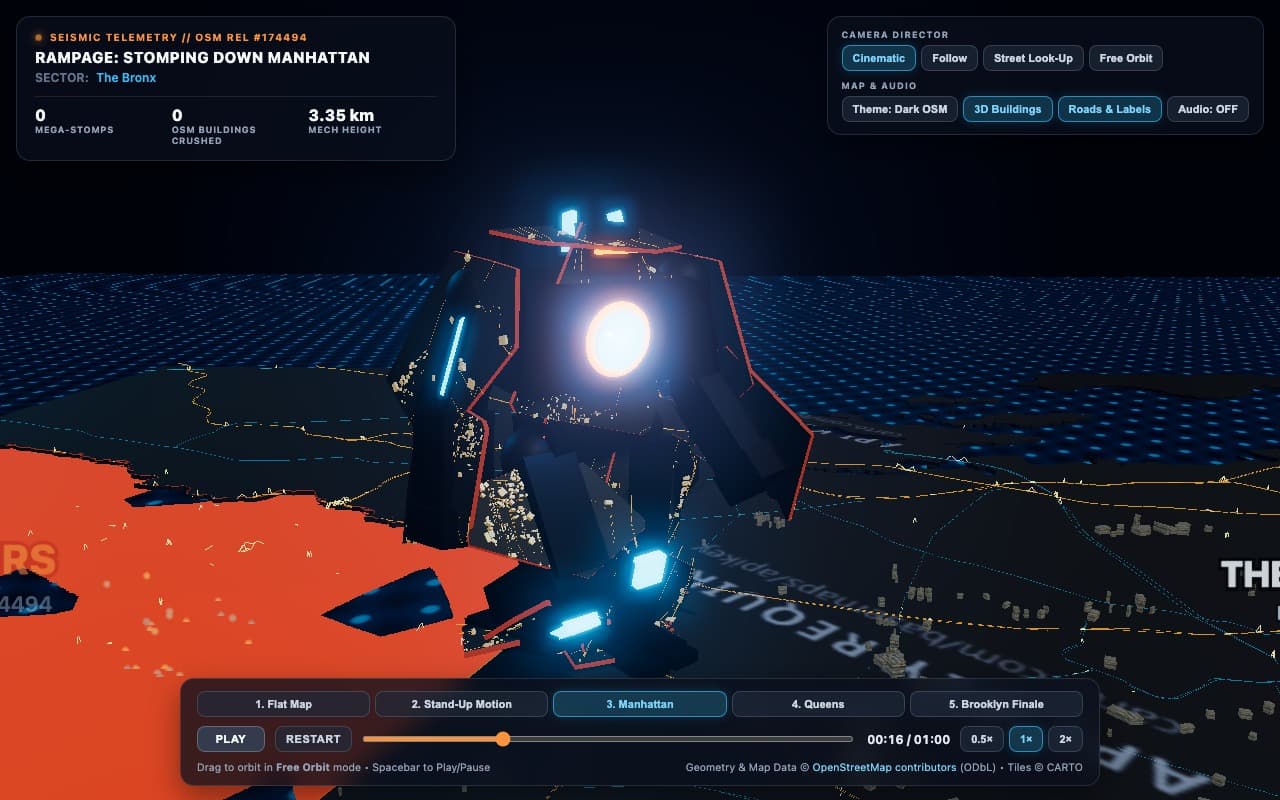
Son vistas seleccionadas de los proyectos públicos del autor. Abre los originales para reproducir los movimientos; las capturas no comparan la velocidad de ejecución.
Al abrir las demos, observa tres aspectos concretos:
- Restricciones geográficas: Comprueba cómo el contorno de Yonkers se convierte en el meca y si coinciden el mapa, las carreteras y las etiquetas de región. El proyecto Fable identifica sus edificios como inventados.
- Continuidad del movimiento: Reproduce la transformación, la incorporación y la marcha completas. Observa transiciones, posición de los pies y contacto con el suelo, en vez de juzgar la animación por una imagen fija.
- Interacción útil: Prueba arrastre, zoom y repetición en Fable, y cámaras, capítulos y velocidad en Carbon. Comprueba si los controles ayudan a inspeccionar y recorrer el resultado.
El caso sirve para examinar cómo cada modelo resuelve los requisitos de espacio, animación y datos. Los entornos de herramientas, los detalles del prompt y el número de peticiones son distintos. No hay duración ni coste total equiparables, por lo que no demuestra un ganador general. El autor identifica Fable como medium; el nivel de razonamiento de Carbon no se especifica en este relato.
Para un prototipo interactivo, da las mismas entradas a ambos. Comprueba si la escena cumple el encargo, si el código se ejecuta, si es fácil modificarlo y cuántos turnos adicionales hacen falta. Incluye tanto el resultado visual inicial como la mantenibilidad en la aceptación.
¿Cómo repartir modelo principal, escalado y revisión en EvoLink?
En un producto existente, conserva el proceso principal estable y asigna a Carbon o Fable los trabajos difíciles ya identificados. Una API unificada permite mantener clave, saldo y gestión de llamadas mientras la elección del modelo pasa a la configuración de la aplicación. Las herramientas y los parámetros de razonamiento de cada modelo siguen su propia documentación.
Empieza con una de estas tres organizaciones:
/swarm de Antigravity y Claude Advisor tienen sus propias condiciones de producto y canal; con una API unificada, el framework o la aplicación elegidos aportan la orquestación correspondiente.Fijar la configuración final con tareas reales
Elige correcciones de errores, cambios en varios archivos o tareas de herramientas recientes con criterios de aceptación explícitos. Da a ambos la misma revisión de código, entradas y permisos de herramientas.
Guarda cuatro tipos de resultados por tarea: aceptación, todos los costes de modelos y herramientas, tiempo total hasta la entrega e intervención humana o trabajo repetido. En los fallos que merezca la pena perseguir, sube el esfuerzo o escala de modelo manteniendo las mismas reglas de reintento.
Preguntas frecuentes
¿Qué pruebo primero con un presupuesto limitado?
Para acercarte a las configuraciones de programación más exigentes, empieza con Carbon medium. Si la calidad requerida lo permite, compara también Fable medium: en CursorBench su coste y su puntuación son inferiores. Decide con tus propios criterios de aceptación.
¿El mayor precio de Fable lo hace siempre mejor para programar?
Fable puntúa más alto en algunas evaluaciones de repositorios, y Carbon también es fuerte en el CursorBench actual. Elige según la tarea y compara entrega y trabajo repetido a distintos niveles.
¿Carbon es un 75 % más barato?
Sus tarifas base del proveedor para entrada sin caché y salida son un 75 % inferiores en el lanzamiento y un 50 % después. Esa proporción no equivale al ahorro real por tarea ni describe directamente el precio de tu cuenta EvoLink.
¿Comparar ambos en medium es justo?
Sirve para comparar el efecto práctico de esas configuraciones, pero el mismo nombre no significa igual presupuesto de cómputo. Registra modelo, herramientas, consumo, duración y aceptación.
¿Cuál es más rápido?
Mide espera hasta el primer token, respuesta completa y finalización de toda la tarea en el canal y nivel previstos. Razonamiento, herramientas y trabajo repetido cambian el resultado.
¿Basta con cambiar el nombre del modelo?
El acceso unificado reduce la configuración repetida del cliente. Herramientas, razonamiento, mensajes y errores siguen necesitando comprobaciones por modelo. Para un traspaso, transmite el material necesario y reconstruye los mensajes para el destino.
¿Puedo usar directamente el otro modelo para revisar código?
Empieza con una revisión independiente y exige un desencadenante y evidencia de reproducción por problema. El acuerdo entre modelos sigue necesitando validación con pruebas. Incluye el coste de revisión y el tiempo dedicado a falsos positivos en el total.