Comparación
MiniMax M3.1 Flash vs GPT-6 Luna: entradas y herramientas

EvoLink Team
Equipo de producto
19 de octubre de 2026
4 min de lectura
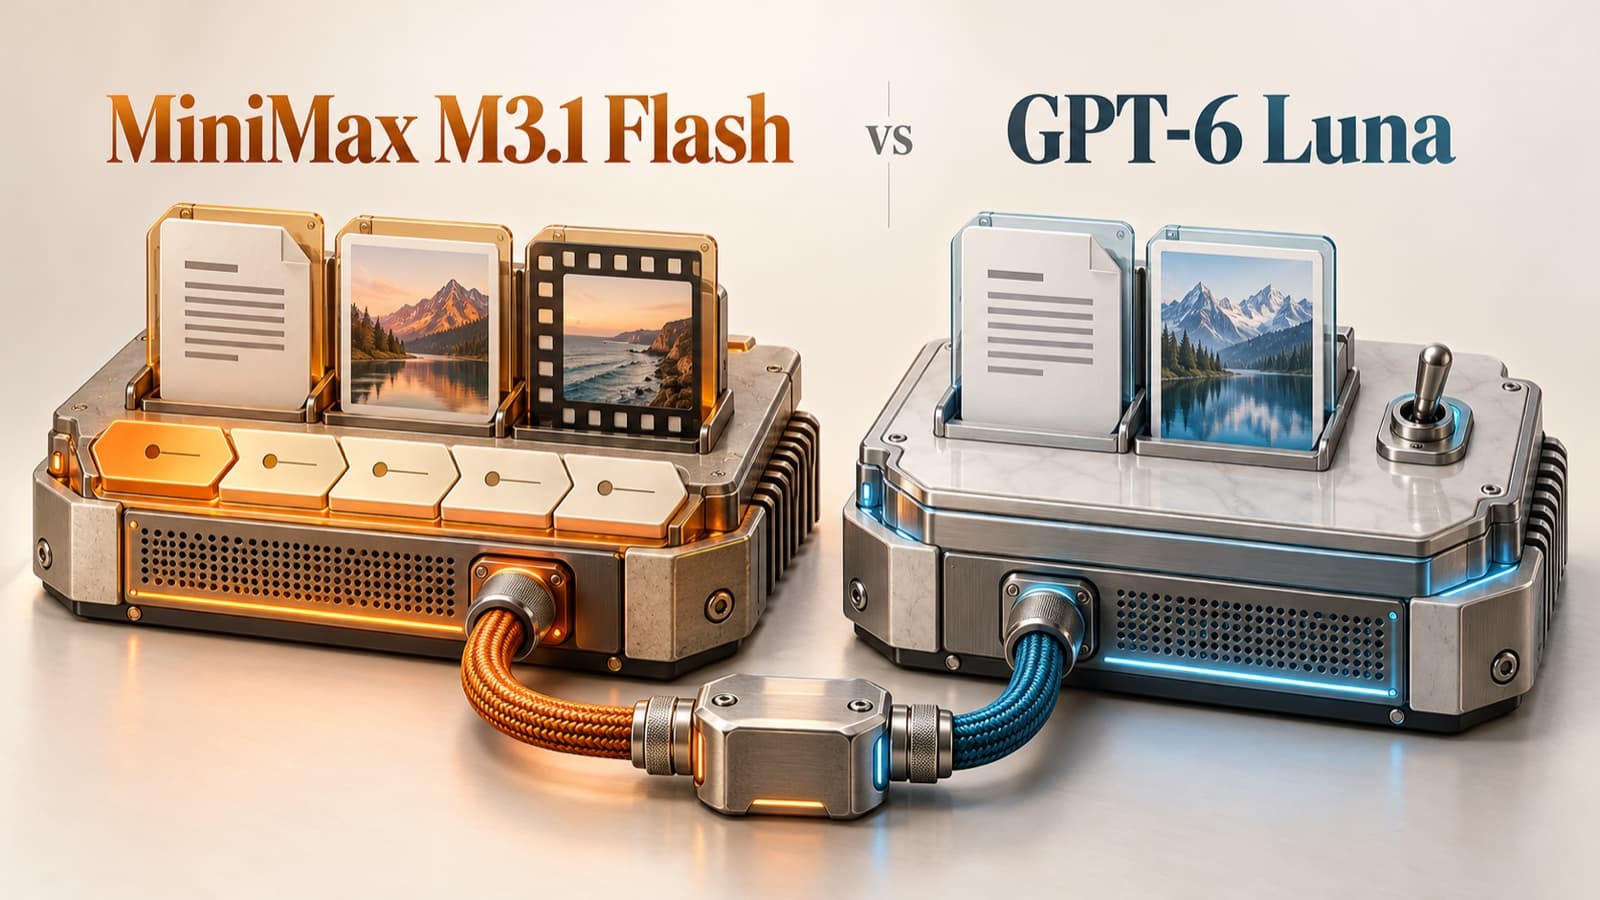
Compara MiniMax M3.1 Flash y GPT-6 Luna por las entradas y el protocolo de herramientas que requiere tu aplicación antes de interpretar precios. Ambos tienen contexto de alrededor de un millón de tokens, pero no comparten configuración intercambiable. MiniMax acepta vídeo y mantiene razonamiento; Luna acepta texto e imágenes, puede desactivarlo y admite hasta 128 000 tokens de salida.
Es una comparación de contratos documentados, no un benchmark de calidad. Las páginas de MiniMax y Luna mantienen acceso y tarifas actuales de EvoLink. Aquí se decide entre estos dos modelos exactos, sin clasificación general de modelos de programación ni migración entre generaciones GPT.
MiniMax M3.1 Flash vs GPT-6 Luna: entradas y herramientas
| Parámetro | MiniMax M3.1 Flash | GPT-6 Luna |
|---|---|---|
| Proveedor | MiniMax | OpenAI |
| ID oficial | MiniMax-M3.1-Flash | gpt-6-luna |
| Enfoque | Programación, agentes, multimodal y contexto largo | Resumen, clasificación y extracción acotados a gran escala |
| Contexto | 1 000 000 tokens | 1 050 000 tokens |
| Entradas | Texto, imágenes y vídeo | Texto e imágenes; sin audio ni vídeo nativos |
| Salida | Texto | Texto |
| Niveles | low, medium, high, xhigh, max | none, low, medium, high, xhigh, max |
| Valor por defecto | max; no se desactiva | medium; none desactiva razonamiento |
| Funciones | Razonamiento intercalado; guardar respuesta assistant completa entre turnos | Responses combina razonamiento y funciones; Chat Completions exige reasoning_effort: none para funciones |
| Precio oficial entrada/salida | $0.15 / $0.60 por millón de tokens | $0.10 / $0.50 por millón, Standard hasta 272K tokens de entrada |
| Precio oficial lectura de caché | $0.015 por millón de tokens | $0.01 por millón en el mismo tramo |
Especificaciones y precios de proveedor revisados el 19 de octubre de 2026: invocación MiniMax, precios MiniMax y referencia Luna de OpenAI. Son tarifas nativas. Luna factura escritura de caché aparte; con más de 272K tokens de entrada, entrada y caché duplican tarifa y salida pasa a 1,5 veces para toda la petición. En EvoLink usa las secciones existentes de MiniMax y Luna.
Qué cambian estas diferencias en la aplicación
Vídeo: MiniMax documenta esta entrada. Para Luna debes extraer fotogramas o un texto transcrito primero. Es preprocesamiento de la aplicación, no capacidad nativa de vídeo. Confirma además la estructura multimedia que admite la pasarela elegida.
Razonamiento: los cinco niveles MiniMax ajustan profundidad sin apagarlo. Luna añade
none y usa medium por defecto. Haz explícita la elección al cambiar. Si la tarea exige no razonar, MiniMax low no cumple el mismo contrato que Luna none.Herramientas: MiniMax conserva historial assistant completo, incluidos
reasoning_content cuando exista y tool_calls, o todos los bloques Anthropic. En Luna, usa Responses si combinas razonamiento y funciones; Chat Completions requiere apagar razonamiento. «Compatible con OpenAI» no prueba el mismo comportamiento de herramientas ni soporte de todas las funciones nativas en una pasarela.Elegir entre los dos modelos mediante EvoLink
EvoLink unifica autenticación, configuración y registros de uso. Primero encaja entrada y protocolo, después evalúa la tarea real. Más contexto indica capacidad, no uso correcto de evidencia. Un token más barato no demuestra menor coste por resultado aceptado.
Conserva prompt, revisión de entrada y herramientas comparables. Comprueba ajuste serializado, respuesta final, ID de herramientas, terminación, reintentos, tiempo total y cargos. Compara el trabajo completo, no solo velocidad de streaming. El idioma y formato exigidos forman parte de aceptación; aquí no se ofrece una clasificación lingüística medida.
Consulta la configuración Luna o la referencia MiniMax de herramientas. La aplicación implementa enrutamiento y recuperación; la pasarela unificada no crea por sí sola una política de respaldo basada en calidad.
Ver las dos configuraciones actuales
Especificaciones, tarifas y entradas de petición están en las páginas de modelo existentes.