Compara GPT-6.1 Terra y Sol en programación, análisis de datos, esfuerzo de razonamiento y coste por tarea.
Himi LiProduct Manager at EvoLink
9 min de lectura
En este artículo
Prueba GPT-6.1 Terra para tareas bien delimitadas: trabajo en pantalla, redacción con material proporcionado y pequeñas correcciones de código. Mantén GPT-6.1 Sol como punto de partida para programación compleja y proyectos en los que olvidar una dependencia genere mucho trabajo adicional.
Terra tiene tarifas Standard más bajas. La cuestión es si una configuración concreta ofrece la calidad que necesita tu tarea. Aumentar el esfuerzo de razonamiento puede cambiar tanto la factura como la espera, así que elegir entre Terra y Sol también implica elegir una configuración.
GPT-6.1 Terra vs GPT-6.1 Sol: diferencias principales
Criterio
GPT-6.1 Terra
GPT-6.1 Sol
Mejor punto de partida
Tareas de pantalla definidas, redacción con hechos proporcionados y correcciones acotadas
Programación compleja y trabajo profesional con muchas dependencias
Entrada / salida Standard por millón de tokens
$1 / $5
$2 / $10
Entrada en caché por millón de tokens
$0.05
$0.10
Esfuerzo de razonamiento
none, low, medium, high, xhigh, max
low, medium, high, xhigh, max
Esfuerzo predeterminado
medium
medium
Llamadas a herramientas
Requieren Responses API
Requieren Responses API
Especificaciones y tarifas oficiales: Terra, Sol y precios. La tabla utiliza tarifas Standard de OpenAI; el contexto largo y otros modos de servicio tienen condiciones propias.
Ambos aceptan texto e imágenes y producen texto. Los dos ofrecen una ventana de contexto de 1.050.000 tokens y hasta 128.000 tokens de salida. La capacidad de contexto no los diferencia. Referencia de Terra; referencia de Sol.
Programación, uso del ordenador y análisis de datos: ¿cuál conviene?
Programación: Terra para una corrección; Sol para un proyecto con partes conectadas
Un fallo de diseño con pasos claros para reproducirlo es un buen candidato para Terra. Una función que afecte a autenticación, facturación y estado compartido da más motivos para usar Sol: pasar por alto una relación puede generar más trabajo del que ahorra la tarifa de tokens. Este reparto sigue las recomendaciones de OpenAI.
Artificial Analysis publica 48 puntos para Terra y 54 para Sol en el Coding Agent Index v2.0. El índice reúne cambios en repositorios, tareas de terminal y preguntas sobre el código. Un único benchmark de terminal no representa todo el trabajo de desarrollo. Análisis de AA; metodología.
Hay una excepción relevante: OpenAI informa de que Terra con esfuerzo max supera a Sol en Terminal-Bench-Science 0.1 a menor coste, aunque sigue recomendando Sol o Astra para la programación más compleja. Un flujo científico de terminal y una gran refactorización son trabajos distintos. Evaluación de OpenAI.
Uso del ordenador y redacción: Terra merece una primera prueba
Terra puede encajar en flujos como leer una factura e introducir sus campos en una aplicación. Las evaluaciones de comprensión visual y uso del ordenador de OpenAI muestran su rendimiento en esas tareas. OpenAI.
También conviene probarlo cuando los hechos y el resultado esperado están claros: convertir notas de versión en documentación para clientes o adaptar una propuesta a un público definido. Si hay que reconciliar pruebas contradictorias dentro de un proyecto complejo, Sol es un punto de partida más prudente. Guía de selección.
Análisis de datos: las preguntas difíciles pueden justificar Sol
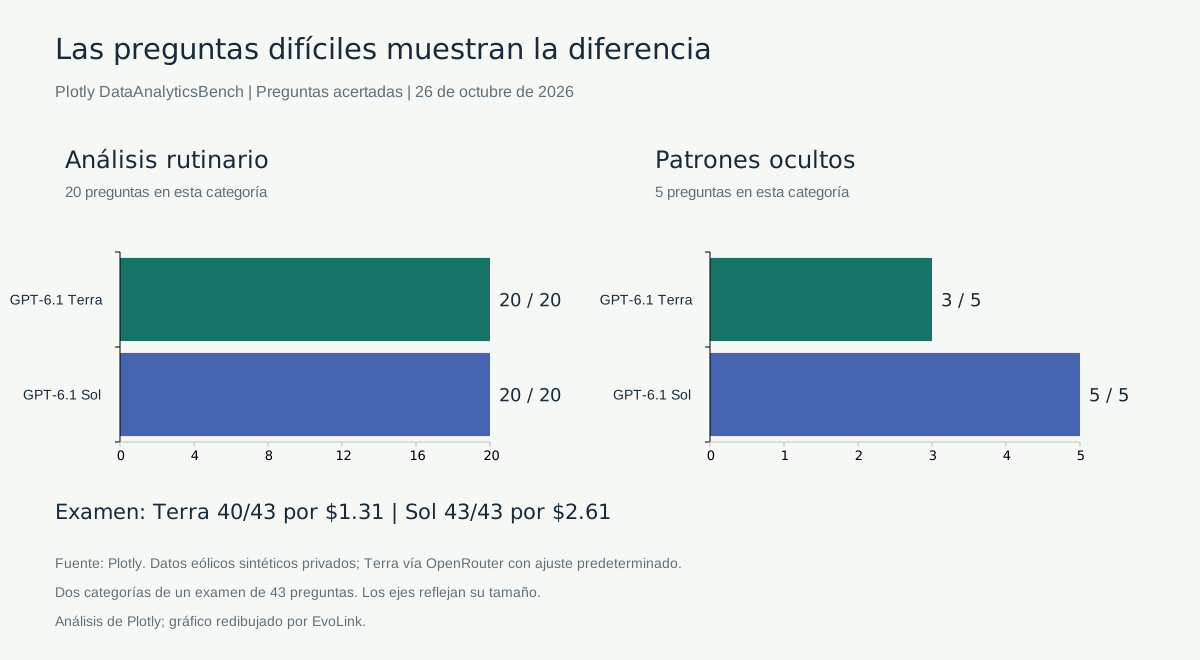
El examen de Plotly de 43 preguntas ofrece un ejemplo concreto. Terra resolvió 40 por $1.31 y Sol las 43 por $2.61. Ambos acertaron las 20 preguntas de análisis rutinario. En patrones ocultos, Terra encontró tres de cinco y Sol los cinco. Resultados de Plotly.
Plotly: ambos modelos aciertan 20 de 20 preguntas rutinarias; Terra encuentra 3 de 5 patrones ocultos y Sol 5 de 5.
Las consultas rutinarias y la búsqueda de patrones ocultos pueden llevar a elecciones distintas. Gráfico redibujado a partir de los resultados publicados por Plotly.
Terra resulta así un candidato razonable para consultas recurrentes bien definidas. Sol merece atención cuando hay que descubrir algo que la pregunta aún no menciona. El examen utilizó datos sintéticos privados de parques eólicos; Terra se ejecutó mediante OpenRouter con el razonamiento predeterminado y mucha reutilización de caché. Condiciones; diseño del benchmark.
Terra high vs Sol medium: ¿qué esfuerzo de razonamiento elegir?
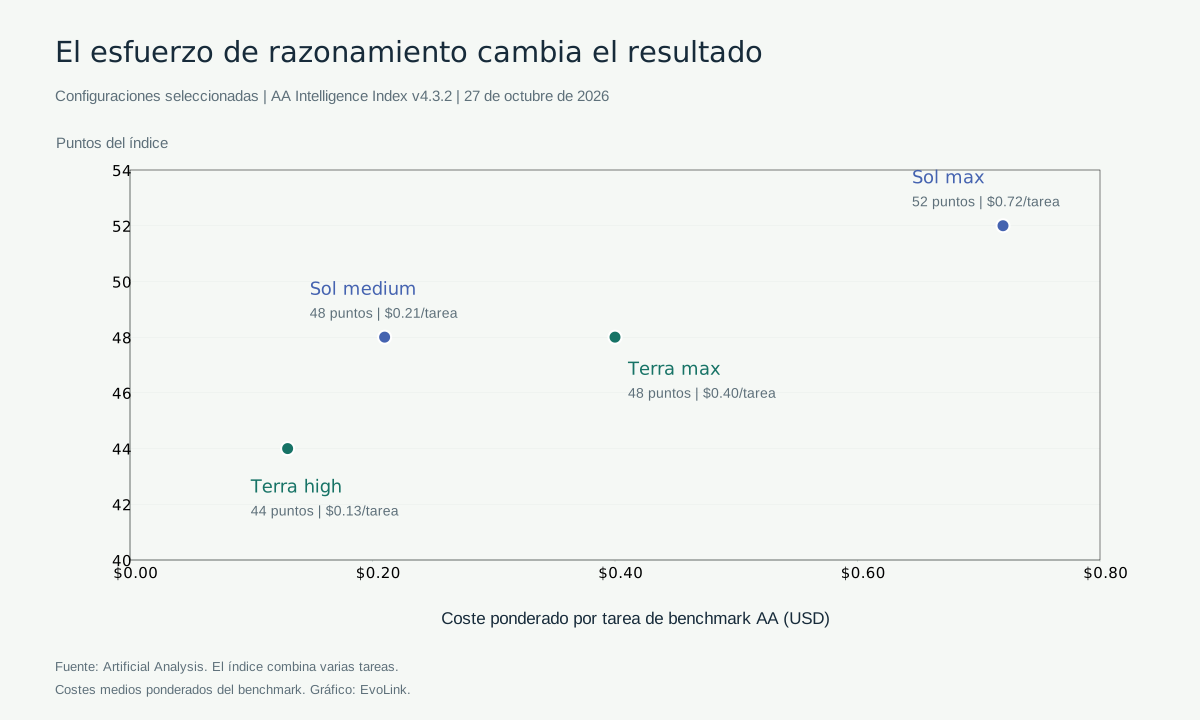
Terra high tiene un coste menor en la comparación de AA, pero Sol medium obtiene la puntuación global más alta.
Modelo y esfuerzo
AA Intelligence Index
Coste medio ponderado por tarea de benchmark AA
GPT-6.1 Terra · high
44
$0.13
GPT-6.1 Sol · medium
48
$0.21
GPT-6.1 Terra · max
48
$0.40
GPT-6.1 Sol · max
52
$0.72
Datos del 27 de octubre de 2026: clasificación de proveedores de AA y max frente a max. El índice expresa puntos compuestos, no un porcentaje de tareas superadas. Los costes son medias ponderadas de las tareas del benchmark.
Configuraciones AA: Terra high logra 44 puntos a $0.13 por tarea, Sol medium 48 a $0.21, Terra max 48 a $0.40 y Sol max 52 a $0.72.
Terra max y Sol medium muestran 48 puntos, pero sus resultados por componente difieren: Terra max obtiene 56 % frente a 48 % en Terminal-Bench 4.0, mientras Sol medium gana 63 % a 60 % en AutomationBench-AA. Coincidir en una puntuación redondeada no significa resolver igual tu tarea. Terra max; Sol medium.
AA también identifica configuraciones eficientes distintas según el objetivo: Terra low y medium están en su frontera de inteligencia general frente a coste; low y xhigh, en la de programación. Usar siempre medium o evitar siempre los niveles altos pasa por alto esa diferencia. Análisis de AA.
¿Terra es realmente más rápido y barato que Sol?
Mide la velocidad de salida y la espera hasta la primera respuesta
Artificial Analysis informa por separado de la velocidad de salida y el tiempo hasta el primer token para cada configuración y proveedor. Las medidas cambian; consulta el endpoint que quieras utilizar. Clasificación AA.
En un asistente interactivo importa cuándo empieza la respuesta. En un agente con varios pasos de herramientas, importa cuándo se guarda o entrega el resultado. Las definiciones de rendimiento de AA distinguen esas medidas. Su página también calcula el tiempo para una respuesta de 500 tokens, que no equivale a completar una tarea real de programación o escritorio.
En DataAnalyticsBench de Plotly, con 43 preguntas, la mediana desde la pregunta hasta la respuesta final, incluidas las consultas, fue de 15 segundos para Terra y 18 para Sol. Terra acertó 40 preguntas y Sol 43. La prueba usó datos sintéticos privados de parques eólicos; Terra se ejecutó mediante OpenRouter con su razonamiento predeterminado. Resultados de Plotly; condiciones de Terra.
Una tarifa menor no decide el coste total del trabajo
Con el mismo número de tokens facturables en Standard, la entrada y la salida de Terra cuestan la mitad que las de Sol. Si el esfuerzo cambia el consumo, también cambia la proporción. En max, AA publica $0.40 frente a $0.72 por tarea de benchmark, aproximadamente un 44 % menos para Terra. Entre niveles distintos, Sol medium es más barato que Terra max. Tarifas oficiales; AA max/max; clasificación.
AA calcula su coste con medias ponderadas de evaluación y cargos por tokens. Para un resultado que tu equipo acepta en producción, resulta más útil esta medida. Definición de AA:
Coste por tarea aceptada = gasto total en modelos y herramientas, incluidos intentos fallidos ÷ número de tareas aceptadas
Registra también el tiempo de revisión humana. Una respuesta barata que requiera varias correcciones puede ser peor opción que una tarea acotada que Terra complete bien a la primera. El ahorro depende de la frecuencia con la que el flujo consigue un resultado aceptable.
¿Cambiar a Terra, mantener Sol o usar ambos?
Empieza por una clase de tareas bien definida:
Tu trabajo
Elección inicial
¿Cuándo cambiarla?
Corrección local de código reproducible
Evaluar Terra
Errores repetidos de alcance o regresiones olvidadas favorecen mantener Sol
Funcionalidad o refactorización en archivos desconocidos
Mantener Sol como referencia
Ampliar Terra cuando gestione las dependencias con fiabilidad
Pantallas, formularios y redacción con material proporcionado
Evaluar Terra
Campos guardados incorrectos o hechos omitidos requieren una entrada más clara o un modelo más capaz
Análisis recurrente con preguntas conocidas
Evaluar Terra
Patrones ocultos y preguntas difíciles dan más motivos para Sol
Un flujo que ya funciona bien con Sol
Mantenerlo y probar Terra en una parte acotada
Cambiar cuando calidad, coste y espera lo justifiquen
Una configuración mixta puede ser útil: Terra para lo que resuelve bien y Sol para lo más difícil. La escalada necesita una señal comprobable, como un test fallido o un campo obligatorio ausente en un registro guardado. La confianza del modelo no sustituye a la verificación.
Compara ambos con las mismas entradas representativas y criterios de aceptación. Cambia el esfuerzo por separado del modelo para identificar qué provoca una diferencia. Elige después el par que cumpla calidad y tiempo de respuesta con un coste aceptable.
Comprueba también la vía de acceso
La pasarela API unificada de EvoLink permite gestionar modelos en una integración común. Consulta las páginas de GPT-6.1 Sol y GPT-6.1 Terra para ver acceso y precios actuales. La ruta elegida debe admitir las herramientas que necesite el flujo de producción.
Preguntas frecuentes
¿GPT-6.1 Terra programa mejor que Sol?
Sol tiene la mayor puntuación compuesta de programación de AA. Terra sigue siendo un candidato para correcciones acotadas y determinadas tareas de terminal; OpenAI también publica una ventaja en su evaluación científica. El tipo de tarea importa. AA; OpenAI.
¿Terra high equivale a Sol medium?
No hay una equivalencia fija. En los datos de AA, Terra high tiene menor puntuación global y menor coste medio del benchmark. Incluso Terra max, que iguala la puntuación mostrada de Sol medium, tiene resultados diferentes por tarea. AA; Terra max; Sol medium.
¿Ambos utilizan la misma API para llamar a herramientas?
OpenAI documenta Responses API para las herramientas de ambos modelos. Comprueba también que tu ruta o cliente admita ese flujo. Referencia Terra; referencia Sol.

 Himi LiProduct Manager at EvoLink