

Gemini 4 Argon vs GPT-6 Astra: código y costes

| Tu situación | Por dónde empezar | Pruebas necesarias antes del cambio |
|---|---|---|
| Astra ya supera tus pruebas de código | Mantenlo en servicio y reproduce las mismas tareas con Argon | Parches aceptados, tiempo de revisión y coste por cambio aceptado |
| Los informes largos o grandes cambios de código alcanzan el límite de salida | Prueba Argon con un presupuesto de salida adecuado a la tarea | Resultados completos que superen la revisión dentro de los límites de tiempo y gasto |
| Tu agente depende del comportamiento específico de Responses en Astra | Conserva el flujo y aísla una comparación portable | Comportamiento equivalente de herramientas y beneficio de migración medido |
| Un modelo más pequeño ya resuelve las tareas rutinarias a bajo coste | Conserva esa referencia económica | Mejora frente a esa referencia, no solo frente a Astra |
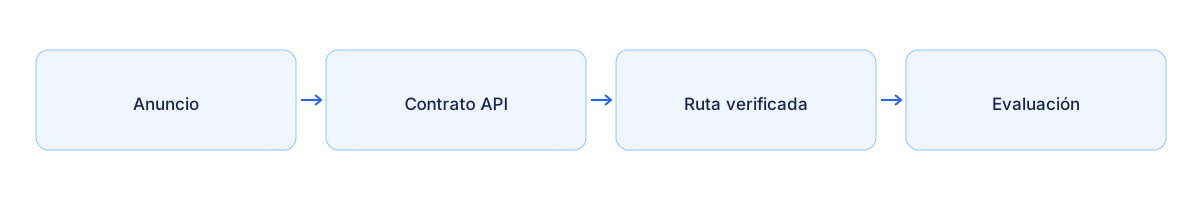
¿Qué es realmente comparable hoy?
| Pregunta | Gemini 4 | GPT-6 Astra | Decisión segura |
|---|---|---|---|
| Estado oficial del producto | Anunciado · Acceso restringido | Lanzado por OpenAI el 3 de septiembre de 2026; acceso por API ampliado desde el 4 de septiembre | Ya se pueden comparar tarifas nominales y evaluaciones del proveedor; falta la prueba de EvoLink con la misma carga y condiciones. |
| ID de API del proveedor | El anuncio no lo establece; usa el ID configurado por EvoLink que aparece en la página del modelo para solicitudes al gateway | gpt-6-astra (OpenAI); sin alias genérico gpt-6 | Distingue los IDs de proveedor y gateway; usa el valor documentado de la ruta elegida |
| Especificaciones publicadas (contexto, salida, entradas) | Google anuncia un límite de salida de 1 millón de tokens para razonamiento y generación prolongados. No es una ventana de contexto de entrada confirmada ni una garantía sobre parámetros de EvoLink. | Contexto de 1,05M de tokens, 128K de salida máxima, entrada de texto e imagen, salida de texto (OpenAI) | No infieras los límites de Gemini 4 a partir de Gemini 3.x |
| Precio de lista | Google anuncia 2 dólares por millón de tokens de entrada y 10 por millón de salida durante el período inicial; después serán 4 y 20 dólares. No se ha anunciado cuándo termina la promoción. Son tarifas de Google, no una oferta de EvoLink. | $10 de entrada / $50 de salida por 1M de tokens; entrada en caché $1 (nivel Standard de OpenAI) | Ya se pueden comparar tarifas nominales y evaluaciones del proveedor; falta la prueba de EvoLink con la misma carga y condiciones. |
| Superficie de tool calling | No publicada | Solo API Responses; OpenAI documenta que Chat Completions no admite function calling con Astra | Mueve los bucles de herramientas a Responses independientemente de la decisión sobre Gemini |
| Ruta de EvoLink | Gemini 4 Argon está disponible a través de EvoLink. Consulta los precios actuales y el ejemplo de solicitud en la página del modelo. | Invocable; ID de modelo de solicitud gpt-6-astra | Fija la referencia sobre la ruta verificada |
| Prueba con la misma carga | Ejecútala mediante EvoLink; aquí no se atribuyen resultados | Compara con tu referencia actual | Ejecuta una comparación por carga de trabajo a través de EvoLink y conserva la referencia actual, los criterios de aceptación y el respaldo durante replay, sombra y canary. El acceso API permite evaluar; no demuestra una ventaja en calidad o coste. |
Las evaluaciones de Google permiten una comparación inicial, pero no son pruebas de EvoLink en igualdad de condiciones. No demuestran latencia, coste por tarea aceptada ni un ganador universal. La tabla incluye un resultado favorable a Argon y otro en el que queda por detrás.
Evaluaciones publicadas por Google
| Evaluación | Gemini 4 Argon | GPT-6 Astra |
|---|---|---|
| DeepSWE v1.1 | 77.9% | 74.1% |
| FrontierSWE v2 | 55.0% | 65.5% |
Lee los ajustes antes de interpretar la diferencia. La metodología de Google utiliza pass@1 salvo indicación contraria y, en general, el nivel de thinking más alto disponible. DeepSWE combina una ejecución de Argon con mini-swe y resultados comparativos de rankings públicos o fichas de sistema; FrontierSWE procede del ranking de Proximal. No son dos modelos ejecutados de nuevo en un mismo entorno de EvoLink. Conserva la versión del benchmark, el entorno, el ajuste de razonamiento y la fuente junto a cada puntuación; no conviertas diferencias en puntos porcentuales en una predicción de éxito en producción.
| Campo de evidencia | DeepSWE v1.1 | FrontierSWE v2 |
|---|---|---|
| Versiones de modelo | Gemini 4 Argon / GPT-6 Astra | Gemini 4 Argon / GPT-6 Astra |
| Entorno y fuente de puntuación | Argon: ejecución con mini-swe; Astra: ranking público citado por Google | Ranking de Proximal citado por Google |
| Razonamiento y métrica | Google indica el nivel de thinking más alto disponible y pass@1 salvo excepción; no se ha establecido que los ajustes sean idénticos | Consulta los ajustes específicos en la metodología enlazada; no se ha establecido que los presupuestos sean idénticos |
| Fecha de revisión de evidencia | 13 de octubre de 2026; no es la fecha de una ejecución equivalente | 13 de octubre de 2026; no es la fecha de una ejecución equivalente |
| Límite de interpretación | Fuentes distintas; no es una comparación controlada de EvoLink | No predice el éxito en tu repositorio |
Elige el alcance de evaluación antes de mover tráfico
Empieza por una tarea que puedas puntuar: reparar un repositorio, reescribir un documento o un flujo de herramientas con estado final conocido. Fija la entrada de referencia, los criterios de aceptación, el presupuesto de reintentos y el límite de tiempo. La mayor salida de Argon solo aporta valor si ayuda a completar esa tarea; no justifica aumentar el presupuesto de todas las solicitudes.
Mide el trabajo de integración además de los tokens: adaptar un bucle de herramientas, cambiar la gestión de estado y mantener un segundo parser puede costar más que pequeños ahorros por solicitud. Promueve solo las clases de tareas cuyo beneficio observado compense ese trabajo.
Qué tendría que adaptar tu flujo de OpenAI para Gemini
model. No hace idénticas las semánticas nativas de cada proveedor: el manejo de esquemas de herramientas, los límites de los eventos de streaming, los controles de razonamiento, la mecánica de caché, los códigos de error y la identidad devuelta en la respuesta siguen definidos por el contrato de cada proveedor. Una sola clave API en un gateway no garantiza que cada función nativa del proveedor se comporte igual entre proveedores. La página de Argon describe la integración con EvoLink. La columna derecha enumera comprobaciones de compatibilidad de tu aplicación; no promete que todas las funciones nativas estén mapeadas.| Superficie | Qué documenta Astra hoy (OpenAI) | Qué verificar en la ruta de Argon |
|---|---|---|
| Protocolo de petición/respuesta | Endpoints Responses, Chat Completions y Batch | Usa el ejemplo Chat Completions de EvoLink o el formato nativo de Gemini; prueba el parser de respuesta y los campos necesarios en vez de reenviar sin cambios un payload de Responses |
| Esquema de herramientas/funciones | Function calling solo en Responses; tool calling asíncrono documentado | Formato del esquema, soporte paralelo y asíncrono, modos de tool choice, comportamiento con tool choice forzado; comprobar la documentación de la ruta elegida y la traza de tu aplicación |
| Manejo de estado y conversación | Estado basado en Responses; configuration_update cambia el esfuerzo a mitad de conversación conservando la caché — para solicitudes standard de un solo agente; revisar los límites de compatibilidad documentados | Cómo se transportan entre turnos el estado multiturno, los resultados de herramientas previos y los prefijos en caché; comprobar la documentación de la ruta elegida y la traza de tu aplicación |
| Streaming | Streaming admitido; redirección a mitad de turno mediante response.steer por WebSocket | Forma de los eventos, entrega parcial de argumentos de herramientas, informe de uso dentro del stream; comprobar la documentación de la ruta elegida y la traza de tu aplicación |
| Contratos de reintento y error | Límites por nivel de cuenta publicados en la documentación actual del modelo; los límites upstream no son los de la ruta de EvoLink; HTTP 400 con esfuerzo none o minimal; la monitorización de desalineación puede detener una tarea de API a mitad de ejecución | Códigos de error, estructura de rate limits, cualquier comportamiento de interrupción por seguridad, guía de reintentos; comprobar la documentación de la ruta elegida y la traza de tu aplicación |
| Controles de razonamiento/thinking | reasoning.effort en low, medium, high, xhigh, max; reasoning.mode standard o pro en Responses; temperature, top_p y logprobs rechazados | Si el thinking está expuesto, presupuestado o siempre activo; qué parámetros de muestreo existen; comprobar la documentación de la ruta elegida y la traza de tu aplicación |
| Caché de prompts | Admitida; prompt_cache_options.ttl acepta solo "30m"; entrada en caché $1 por 1M | Mecanismo de caché, opciones de TTL, precio de lectura y escritura; comprobar la documentación de la ruta elegida y la traza de tu aplicación |
| Facturación de contexto largo | Toda la petición se factura a 2x la entrada y la caché, 1.5x la salida por encima de 272K tokens de entrada | Si existen tramos de precio y dónde están los umbrales; comprobar la documentación de la ruta elegida y la traza de tu aplicación |
| Ruta del gateway | gpt-6-astra en EvoLink; la entrada de imagen a través de EvoLink requiere verificación de ruta por separado | Identidad de modelo devuelta, contadores de uso y registro de facturación en la ruta de EvoLink; verificar durante la integración |
temperature y top_p y el ajuste de la escalera de esfuerzo son trabajo específico de Astra que haces ahora. La columna de Argon es una lista de compatibilidad para la ruta que usarás. Compartir clave reduce la gestión de cuentas, pero no elimina el trabajo de migración del protocolo.Matriz de tareas: programación, agentes multiherramienta, documentos largos
Google sitúa Argon en ingeniería de software, trabajo de conocimiento empresarial y ciberdefensa, y publica evaluaciones. Son resultados del proveedor, no pruebas de EvoLink ni garantías para tu carga de trabajo. Ya se pueden comparar tarifas nominales y evaluaciones del proveedor; falta la prueba de EvoLink con la misma carga y condiciones.
| Clase de carga de trabajo | Qué medir | Qué te permite medir Astra ahora | Condición de entrada para Gemini 4 |
|---|---|---|---|
| Programación a escala de repositorio | Tasa de parches aceptados, tiempo de corrección humana, reintentos por cambio aceptado, tokens por cambio aceptado | OpenAI posiciona Astra para programación y razonamiento complejo; ejecuta tu conjunto de tareas en Responses con esfuerzo medium y high para fijar una referencia | Mismo harness, mismo conjunto de tareas, misma rúbrica: una tasa de parches aceptados y un coste por parche aceptado que igualen o superen las cifras congeladas de Astra, con un contrato de modelo publicado detrás del resultado |
| Agentes multiherramienta (uso del ordenador, navegación, API internas) | Finalización de la traza completa, tasa de herramienta incorrecta, tasa de bucles, recuperación tras una llamada a herramienta fallida | OpenAI documenta uso del ordenador, tool calling asíncrono y redirección a mitad de turno; mide con y sin estas funciones nativas y etiqueta los carriles | Un contrato publicado de tool calling y streaming, y después la tasa de finalización en un carril portable equivalente antes de comparar cualquier carril de funciones nativas |
| Documentos largos e investigación | Precisión de recuperación a lo largo del contexto, completitud de la salida, coste por tramo de tamaño de entrada | OpenAI documenta un contexto de 1,05M de tokens y uso en investigación y creación de documentos; registra el coste a ambos lados del umbral de 272K | Límites de contexto y salida publicados, tramos de precio publicados, el mismo conjunto de documentos, coste registrado en cada tramo de tamaño de entrada |
| Tareas rutinarias de alto volumen | Latencia p95, coste por tarea, tasa de errores | A menudo la referencia correcta es un nivel de GPT-5.6 y no Astra | Debe superar la referencia más económica, no solo a Astra |
Dos reglas mantienen honesta la matriz. Primera: el posicionamiento documentado por el proveedor es una hipótesis sobre dónde probar, nunca un resultado. Segunda: una ventaja de función nativa (por ejemplo, las tool calls asíncronas de Astra) debe reportarse como resultado de carril, no convertirse en un ranking universal.
Para conjuntos largos de preguntas técnicas, valida la cantidad y el esquema de respuestas, comprueba de forma independiente una muestra de las derivaciones y vuelve a ejecutar las pruebas de código. Una respuesta que aprovecha la capacidad de salida pero omite preguntas o contradice respuestas anteriores no supera la aceptación. Divide y reintenta dentro del mismo presupuesto total de tarea.
Coste de integración y coste por tarea aceptada
La unidad que importa es el coste por tarea aceptada: todo lo gastado para que una tarea pase la revisión, incluidos tokens de entrada, escrituras y lecturas de caché, tokens de salida, sobrecarga de tool calls, reintentos, peticiones de respaldo y tiempo de corrección humana. El precio por token, por sí solo, oculta la mayor parte.
Del replay a sombra y canary
- Copia el contrato de integración desde la página del modelo. Usa el ID actual y el ejemplo de solicitud de EvoLink. Mantén la ruta en configuración y registra el protocolo de cada carril.
- Reproduce las tareas congeladas. Usa las mismas instantáneas de repositorio, permisos, pruebas de aceptación y presupuesto de salida. Registra fallos y resultados aceptados.
- Ejecuta una muestra representativa en sombra. Mantén Astra en servicio y puntúa por separado las salidas de Argon. Incluye solicitudes largas y recuperación de herramientas fallidas, no solo ejemplos cortos que funcionan.
- Despliega una clase de tareas en canary. Fija de antemano proporción de tráfico y ventana de observación. Amplía solo si la tasa de aceptación, el coste y la latencia cumplen los umbrales; conserva la referencia para revertir.
Comprueba juntos metadatos de respuesta, uso y facturación. La etiqueta del modelo devuelta sirve para comprobar coherencia; no prueba de forma independiente la identidad del modelo subyacente. Resuelve discrepancias de ruta o facturación antes de ampliar tráfico.
Cuándo mantener tu enrutamiento actual
Un Gemini 4 lanzado no desplaza automáticamente a Astra ni a un nivel de GPT-5.6 más económico. Mantén la ruta actual cuando se cumpla cualquiera de estas condiciones:
- La ruta actual ya cumple el listón de aceptación para esa clase de carga de trabajo y el candidato no mejora el coste por tarea aceptada.
- El candidato no admite un comportamiento de herramientas del que depende tu agente, o solo lo admite mediante una forma que tu gateway no puede mapear.
- La carga de trabajo está regulada y el candidato no ha superado la revisión de residencia de datos, retención o políticas.
- El candidato empeora la latencia p95 o el coste por tarea aceptada sin una ganancia de calidad suficiente para justificarlo.
- La identidad de modelo devuelta en la ruta no está clara, o los registros de uso y facturación no concilian con el modelo solicitado.
El enrutamiento existe para reservar la capacidad cara para las clases de tarea en las que cambia el resultado entregado, no para enviar cada petición al nombre más nuevo.
Un plan en 5 pasos
- Congela la referencia sobre Astra ahora. Guarda tareas representativas, trazas completas, evaluadores y las cifras actuales de coste y latencia por clase de carga de trabajo, con
gpt-6-astraen Responses. - Mantén la selección de modelo en la configuración. Enruta a través del gateway para que un candidato futuro sea un cambio de configuración, no de código; no repartas IDs de proveedor por el código de la aplicación.
- Escribe hoy los umbrales de aceptación y reversión. Tasa de tareas aceptadas, coste por tarea aceptada, latencia p95, presupuesto de errores y el disparador de reversión, fijados antes de ver cualquier resultado del candidato.
- Añade Argon mediante la ruta documentada de EvoLink. Sigue replay, sombra y canary; no heredes límites ni precios de Gemini 3.x.
- Conserva la ruta anterior durante toda la ventana de observación. Mantén Astra (y el respaldo de GPT-5.6) activos hasta que el candidato sobreviva al replay, la sombra y el canary.
FAQ
¿Puedo comparar Gemini 4 y GPT-6 Astra directamente hoy?
Sí: ejecuta las mismas tareas en ambas rutas mediante EvoLink. Este artículo compara evidencias publicadas y define la prueba; no presenta un experimento comparativo de EvoLink ya realizado. Consulta los precios actuales en cada página de modelo.
¿Necesito migrar mi integración de API para usar Gemini 4?
temperature, top_p y los esfuerzos none o minimal. El endpoint compatible con OpenAI de un gateway mantiene constantes tu clave y tu URL base, pero el comportamiento nativo del proveedor, como los esquemas de herramientas, los eventos de streaming y los controles de razonamiento, sigue teniendo que verificarse proveedor por proveedor contra la documentación de la ruta elegida.¿Cómo decido si compensa el trabajo de migración?
Compara el coste de adaptar y mantener la integración con el beneficio medido por tarea aceptada. Mantén la ruta actual en servicio mientras evalúas Argon; un lanzamiento API por sí solo no justifica mover todo el tráfico.
¿Cómo hago comparable el tool calling entre proveedores?
Ejecuta primero un carril portable: las mismas definiciones de herramientas, permisos, presupuesto de reintentos y reglas de parada en ambas rutas, con las funciones específicas del proveedor desactivadas. Después ejecuta carriles nativos (para Astra, tool calling asíncrono y redirección a mitad de turno en Responses) y etiquétalos por separado. Reporta la finalización de la traza completa, la tasa de herramienta incorrecta y la tasa de bucles por carril. Comprueba qué funciones de herramientas admite la ruta de Argon antes de incluirlas en el carril portable.
¿Cuándo puede entrar Gemini 4 en el enrutamiento de producción?
Cuando los resultados de replay, sombra y canary cumplan los umbrales de calidad, latencia y coste fijados antes de probar. Usa la ruta documentada de EvoLink, concilia uso y facturación, y conserva Astra para revertir.
¿GPT-6 Astra es lo mismo que el Project Astra de Google?
gpt-6-astra. El Project Astra de Google es el nombre de un proyecto de investigación y asistente de Google sin relación. Ninguno de los dos es Gemini 4, y ninguno debe usarse como evidencia sobre Gemini 4. Mantén también Gemini 4 separado de Gemma 4, la familia de modelos de pesos abiertos de Google.Fuentes
- Anuncio de Argon de Google — 30 de septiembre de 2026
- Evaluaciones publicadas por Google
- Google: carta de resultados del segundo trimestre de 2026 de Alphabet (declaración de preentrenamiento de Gemini 4)
- Google: anuncio de Gemini 3.6 Flash (declaración de preentrenamiento de Gemini 4)
- Google: catálogo de modelos de la Gemini API
- OpenAI: documentación del modelo GPT-6 Astra
- OpenAI: anuncio de GPT-6 Astra
- Precios de la API de OpenAI
- OpenAI: guía del modelo más reciente (tool calling solo en Responses, parámetros eliminados)
- Estado de la API de Gemini 4 en EvoLink
- API de GPT-6 Astra en EvoLink
- EvoLink: seguimiento de la fecha de lanzamiento de Gemini 4
- EvoLink: Claude Fable 5.1 vs GPT-6 Astra


