Gemini 4 Neon vs Claude Opus 5.5 en programación y coste
Compara Neon y Opus 5.5 con pruebas públicas en el mismo editor y con sus agentes. Usa el coste por parche aceptado para decidir cuándo cambiar.
 EvoLink TeamEquipo de producto
En este artículo
high en tareas de programación recurrentes cubiertas por pruebas automatizadas. Mantén Claude Opus 5.5 como referencia para los flujos de repositorio que tu equipo ya ha validado. Neon ofrece resultados competitivos al modificar varios archivos y tarifas estándar de entrada y salida más bajas. Antes de cambiar, mide la aceptación al primer intento, el tiempo de revisión y si la configuración admite las herramientas que usa el equipo. CursorBench 4.1 · Precios de Google · Precios de AnthropicCompara Gemini 4 Neon y Claude Opus 5.5 en tu entorno de programación
| Configuración actual | Qué probar | Qué determina la elección |
|---|---|---|
| Ambos modelos están disponibles en el mismo editor | Cambia el modelo y mantén editor, herramientas y revisión | Parches aceptados, gasto total e intervención humana |
| El equipo usa mucho Claude Code | Compara Claude Code con Opus y Antigravity con Neon como entornos completos | Instrucciones del repositorio, permisos y traspasos de trabajo |
| Tu aplicación llama a modelos por API | Usa la misma tarea, herramientas autorizadas y validación | Uso correcto de herramientas, parche válido y recuperación tras un fallo |
| El entorno gestiona migraciones poco frecuentes y arriesgadas | Prueba Neon en una repetición o rama aislada | Comprobaciones de compatibilidad y trabajo manual posterior |
Qué miden las dos pruebas de programación
xhigh con Antigravity CLI obtuvo 59 puntos a 6,86 USD por tarea, frente a 58 puntos y 12,61 USD para Opus 5.5 max con Claude Code. Los resultados están redondeados y corresponden a cada combinación de modelo y herramienta. CursorBench 4.1 aporta otra comparación dentro del mismo editor. Evaluación de Artificial Analysis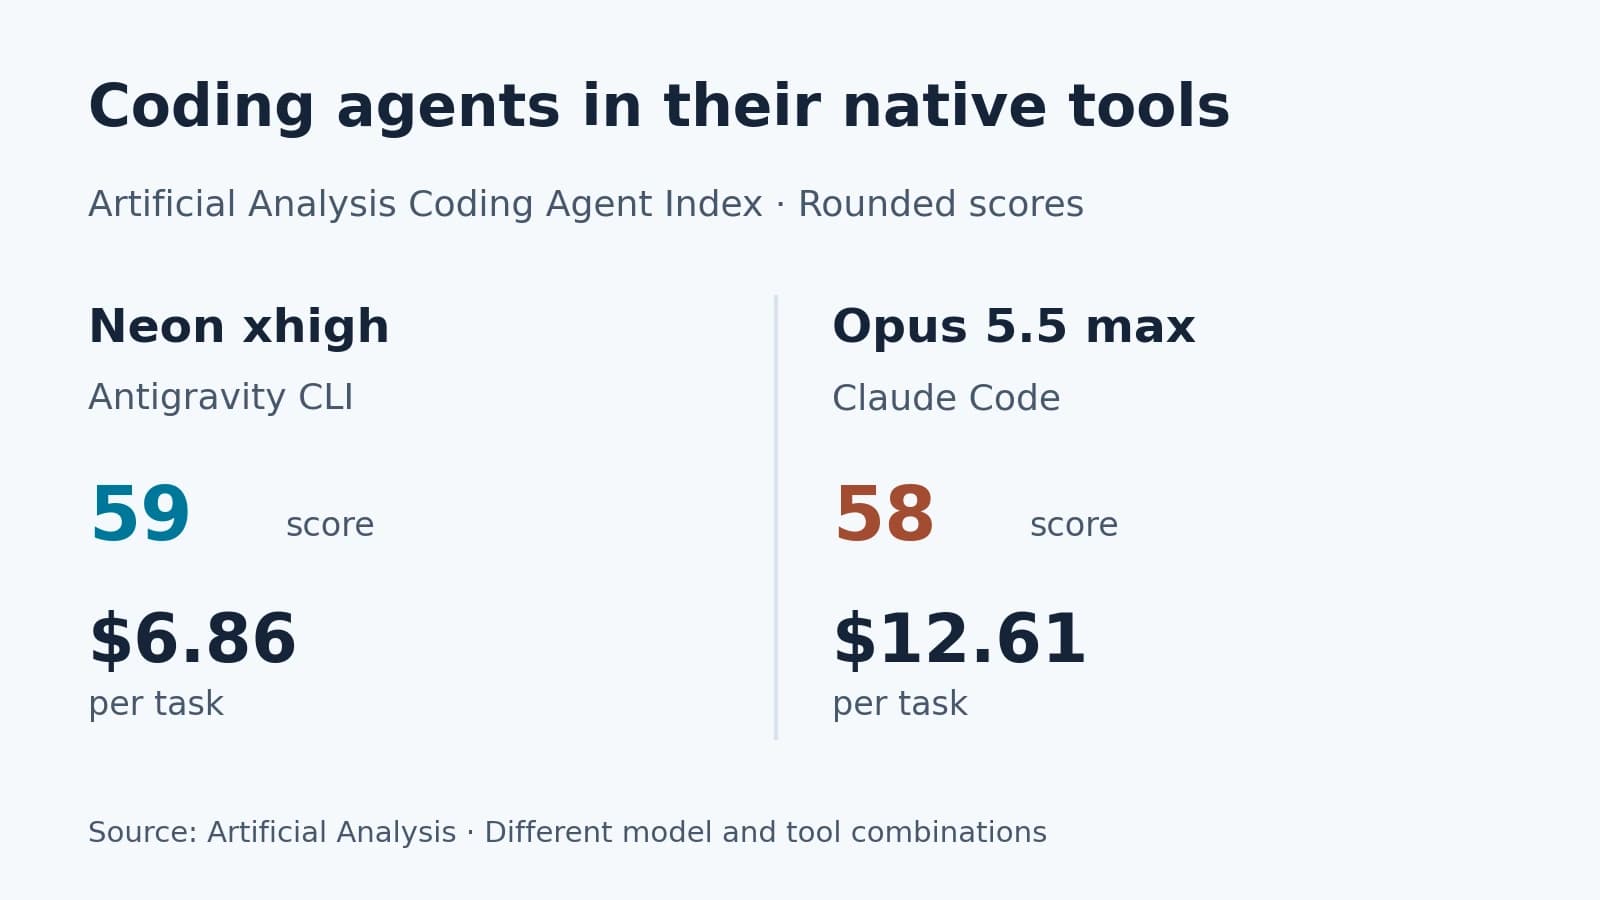
| Configuración en CursorBench 4.1 | Puntuación | Coste por tarea publicado |
|---|---|---|
Neon medium | 57,7 % | 3,07 USD |
Opus 5.5 high | 54,5 % | 3,87 USD |
Neon high | 63,7 % | 6,54 USD |
Opus 5.5 xhigh | 56,7 % | 6,54 USD |
Neon xhigh | 65,4 % | 10,67 USD |
Opus 5.5 max | 58,1 % | 11,88 USD |
high es un buen punto de partida. En los resultados publicados por Google, Opus tiene una pequeña ventaja en Terminal-Bench 4.1 y FrontierCode 2.0. Si tu equipo dedica mucho tiempo a depurar en terminal o a cambios que deben quedar listos para integrar, incluye esos casos en la repetición. Usa los benchmarks para elegir qué probar y tus criterios de aceptación para elegir el modelo. Datos de CursorBench comprobados el 19 de noviembre de 2026. CursorBench · Evaluación de Google DeepMindCuánto influye el entorno del agente en la puntuación
| Configuración SWE-sweep | Neon | Opus 5.5 |
|---|---|---|
| Entorno de cada proveedor | 39,0 % | 10,1 % |
| Entorno común mini-SWE | 12,8 % | 3,6 % |

Las puntuaciones y la distancia entre ambos modelos cambian con el entorno. Google indica que Antigravity CLI puede delegar búsquedas paralelas en el repositorio, algo apropiado para detectar fallos en pruebas como SWE-sweep. Si vas a cambiar el modelo, mantenlo en el mismo entorno cuando sea posible. Si vas a cambiar de IDE, compara las cadenas de herramientas con idénticos permisos y alcance. Incluye el tiempo para aprender a usarlas y revisar el código.
Calcula el coste por parche aceptado
En este ejemplo hipotético con 100 tareas de programación, los totales incluyen los intentos fallidos y los reintentos.
| Ruta | Gasto total en API | Parches aceptados | Coste de API por parche aceptado |
|---|---|---|---|
| Neon | 45 USD | 75 | 0,60 USD |
| Opus 5.5 | 60 USD | 90 | 0,67 USD |
| Neon con menos parches aceptados | 45 USD | 65 | 0,69 USD |
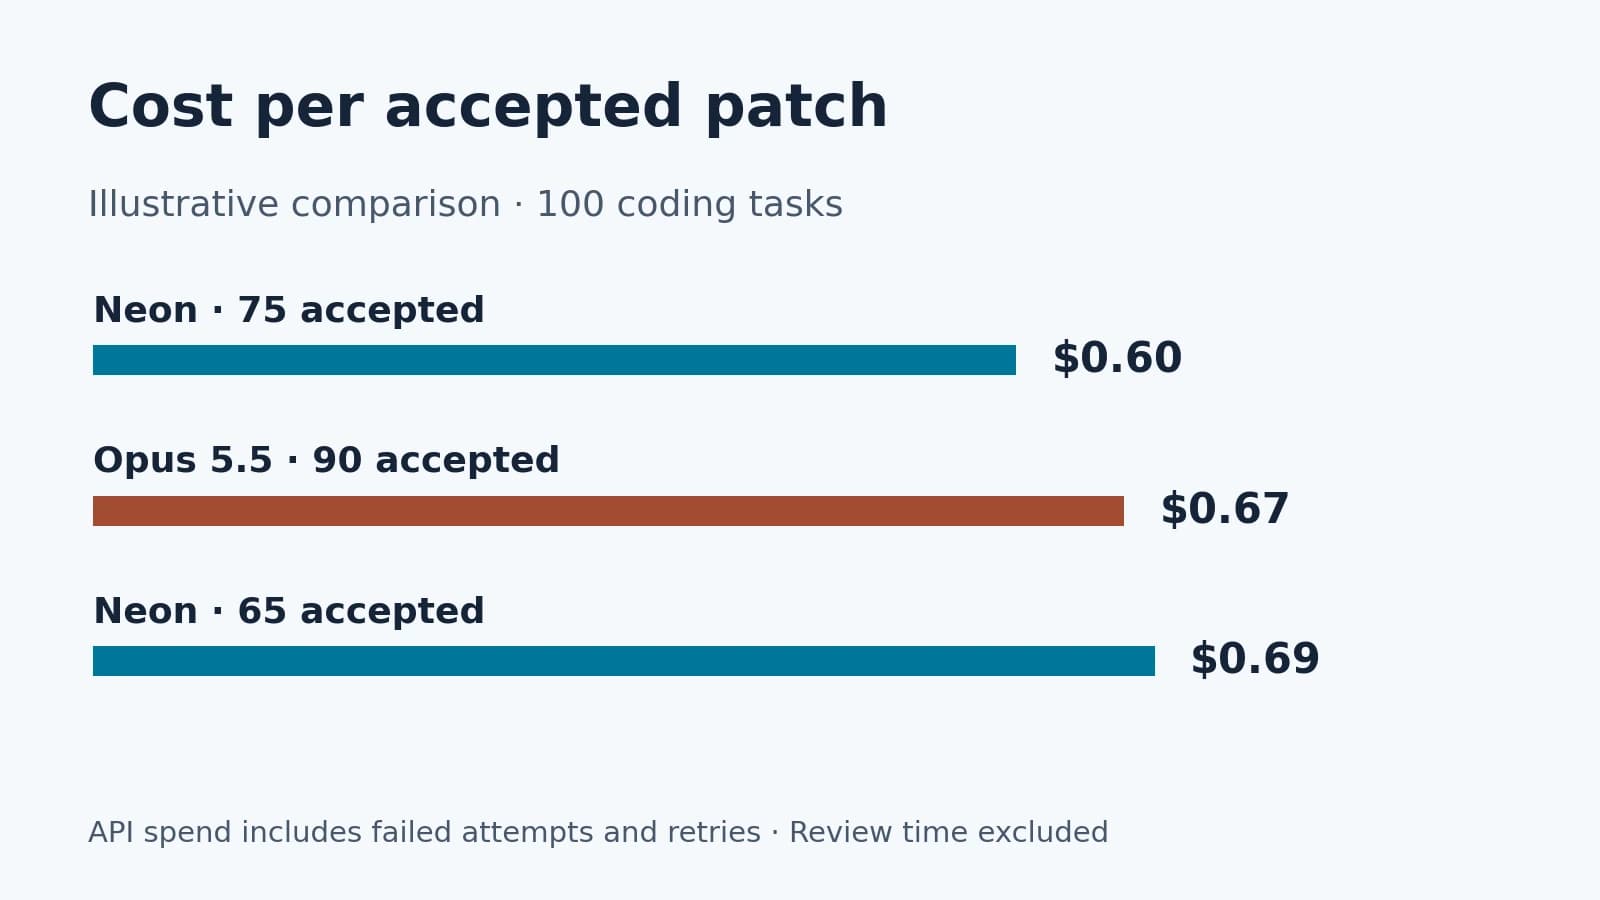
Con el mismo gasto de 45 USD en Neon, una caída de la tasa de aceptación puede hacer que cada parche aceptado cueste más que con Opus 5.5. Suma el tiempo de revisión y las correcciones manuales al gasto en API. Pasar por alto un requisito de compatibilidad en una interfaz compartida puede salir más caro que la propia llamada.
Revisa la integración antes de cambiar de proveedor
high por defecto. El razonamiento adaptativo de Opus 5.5 usa medium de forma predeterminada. Prueba tanto los ajustes explícitos como los valores que desplegarías. Un nombre de nivel igual puede representar un esfuerzo de cómputo distinto. Documentación de Neon · Documentación de Anthropic| Punto de integración | Gemini 4 Neon | Claude Opus 5.5 |
|---|---|---|
| Salida larga de la API nativa | Límite síncrono predeterminado de 65.536 tokens entre razonamiento y salida. Generación larga en interfaces compatibles | Anthropic indica hasta 128K de salida |
| Caché | Aciertos implícitos a 0,15 USD por millón de tokens de entrada en Standard | Lectura a 0,20 USD, escritura a 5 USD por cinco minutos u 8 USD por una hora, por millón |
| Estado de herramientas en varios turnos | Conservar el estado de interacción o las firmas de razonamiento de Google de esa interfaz | Seguir el contrato de resultados de herramientas y razonamiento de Claude Messages |
Diseña una prueba que te ayude a decidir si cambias
Elige tickets recurrentes, como una prueba intermitente que sepas reproducir. Da a cada agente la misma rama, la misma descripción, las mismas herramientas y permisos, el mismo tiempo y el mismo comando de prueba. Aísla cada intento y revisa los cambios con la misma lista, idealmente sin ver el modelo.
Fija los criterios de aceptación antes de revisar parches
Elige unos pocos tickets representativos con resultados medibles. Fija la revisión, el archivo de bloqueo de dependencias, las instrucciones, las herramientas y las reglas de parada. Si usas Claude Code, anota los hooks y comandos que contribuyen a un resultado exitoso. Para comparar los modelos, reproduce las comprobaciones con un ejecutor de pruebas que no dependa de ninguno.
| Qué evaluar | Cómo comprobarlo |
|---|---|
| Funcionalidad | Reproduce el fallo original y consigue que pase la prueba objetivo después del cambio |
| Compatibilidad | Los ejemplos existentes pasan y las entradas antiguas o los clientes conservan el comportamiento esperado |
| Alcance | El parche se ajusta al ticket y las comprobaciones generales siguen activas |
| Recuperación | Si una herramienta se detiene, el agente identifica lo pendiente y evita repetir acciones con efectos secundarios |
Registra por tarea original el primer resultado, el resultado final, el tiempo hasta un diff revisable, los tokens facturados y los minutos de revisión. Si la segunda llamada soluciona un fallo, cuenta ambas y apunta si el revisor aportó datos nuevos. Así queda visible el coste de recuperación y puedes decidir qué tickets conservar en Opus y cuáles mover a Neon.
Preguntas frecuentes
¿Neon programa mejor que Opus 5.5?
Neon va por delante en las configuraciones de CursorBench citadas, y Opus en algunas pruebas de terminal y repositorio. Elige el test que mejor represente tu trabajo.
¿Neon es más barato?
Sus tarifas estándar de entrada y salida son un 25 % menores. El coste por tarea aceptada depende del uso, la caché, los reintentos y la revisión.
¿Conviene probar ambos con el máximo razonamiento?
Incluye esa prueba para los casos difíciles. En tráfico habitual, compara niveles compatibles con tu presupuesto y latencia.
¿Puedo comparar los modelos sin cambiar de editor?
Sí, si el mismo editor admite ambos modelos y las funciones necesarias. Así mantienes fija una variable importante.
¿Puedo cambiar un agente en ejecución solo con el nombre del modelo?
Comprueba primero la integración. Los mensajes de herramientas, los controles de razonamiento y la gestión del estado pueden variar entre APIs.
¿Con qué tarea debería empezar?
Elige un ticket recurrente, reproducible y con criterios de aceptación claros. El resultado te ayudará a elegir una ruta cuando vuelva a aparecer.