Claude Fable 5.5 vs Opus 5.5: ¿cuándo compensa cambiar?

Fable 5.5 vs Opus 5.5: ¿qué se puede comparar hoy?
| Información para decidir | Referencia Opus 5.5 | Candidato Fable 5.5 |
|---|---|---|
| Identidad y acceso | Utilice la ruta documentada actual y verifique su cuenta | No establecidos por las fuentes consultadas |
| Calidad de las tareas | Mida sus propios casos aceptados y fallidos | Aquí no se aportan resultados verificados |
| Coste y latencia | Registre cargos reales, reintentos y duración | Desconocidos hasta poder evaluar una ruta invocable |
| Papel en producción | Mantenerlo si cumple los requisitos | Pendiente; un número de versión no es una prueba de aceptación |
La referencia existente ya es más difícil de superar
xhigh; la mayoría de los demás resultados de Opus de la tabla utilizan max. Son evaluaciones del proveedor de Opus 5.5 y Fable 5.1, no evidencia sobre Fable 5.5 ni mediciones de una ruta EvoLink. Anthropic también indica que estaban activadas las salvaguardas de producción: cuando intervenían, las tareas de ciberseguridad pasaban a Opus 4.8 y las de biología o desarrollo de LLM de frontera, a Opus 5. Los resultados corresponden a esa configuración, no prueban que todas las tareas se ejecutaran exclusivamente en Opus 5.5.medium en Opus 5.5 y high en Fable 5.1. La igualdad de ventanas no resuelve la calidad de recuperación de información; distintos valores predeterminados implican que una prueba sin ajustes puede comparar condiciones de funcionamiento diferentes.En una futura evaluación de Fable 5.5, conserve columnas distintas para tareas únicas, todos los intentos, éxito inicial y éxito final. Un único porcentaje puede ocultar si mejora la primera respuesta o si solo resuelve más casos después de reintentar. Para el enrutamiento, identifique las tareas que Opus aún no resuelve dentro de su presupuesto real: ahí debe justificar su lugar un candidato más caro.
Elija tareas en las que cambiar pueda aportar valor
Una pregunta genérica como «¿qué modelo es más inteligente?» rara vez resuelve una decisión de producción. Empiece por una carga de trabajo en la que mejorar el resultado tenga valor operativo claro. Incluya también tareas rutinarias para evitar que una mejora en un caso difícil oculte regresiones en el tráfico habitual.
| Carga de trabajo | ¿Qué cuenta como éxito? | Fallo que conviene registrar | Pregunta para decidir el cambio |
|---|---|---|---|
| Cambio de código en varios archivos | Pasan las pruebas requeridas y cambia el comportamiento previsto | Arreglos parciales, nuevas regresiones, API inventadas | ¿Reduce la revisión y las reparaciones? |
| Investigación basada en fuentes | Las afirmaciones están respaldadas por las pruebas aportadas | Conclusiones sin respaldo o restricciones omitidas | ¿Mejora las respuestas aceptadas sin exigir más verificación? |
| Flujo con herramientas | Argumentos correctos y estado final previsto | Herramienta equivocada, argumentos inválidos, efectos duplicados | ¿Completa el flujo con fiabilidad? |
| Extracción estructurada rutinaria | Pasan la validación del esquema y las comprobaciones de campos | Campos aparentemente válidos pero incorrectos | ¿Se justifica el coste o retraso adicional con este volumen? |
Son categorías propuestas para evaluar, no afirmaciones sobre funciones admitidas por alguno de los modelos. Pruebe una función únicamente después de confirmar su compatibilidad en la documentación de la ruta y mediante una petición.
Pruebe directamente el razonamiento entre archivos y el uso del contexto
Utilice los mismos casos para la referencia y el candidato. Son propuestas de prueba, no respuestas de modelos; unos pocos éxitos no establecen una clasificación universal.
Haga una comparación controlada una vez verificado el acceso
Antes de ejecutar el candidato, congele un conjunto versionado de tareas con resultados esperados. Incluya éxitos y fallos de Opus: probar solo fallos conocidos puede favorecer al candidato y ocultar lo que estropea. Separe el conjunto de desarrollo usado para ajustar prompts del conjunto reservado para la decisión final.
Mantenga constantes los datos de entrada, las definiciones y el entorno de herramientas, y la rúbrica de evaluación. Registre ID exactos de ruta, fechas, ajustes de petición, versiones de prompts y política de reintentos. No suponga que un parámetro o nivel de effort con el mismo nombre significa lo mismo en ambos modelos. Si necesitan ajustes admitidos diferentes, publíquelos y compare las configuraciones completas bajo las mismas restricciones de presupuesto y latencia.
Repita las tareas cuyos resultados varíen. Si es viable, oculte la identidad del modelo a quienes revisen casos importantes. Publique recuentos y denominadores, no solo porcentajes: «18 de 20 aceptadas» también comunica el tamaño de la muestra. Conserve las valoraciones ambiguas y no convierta una reproducción pequeña en una afirmación universal de rendimiento.
Separe la comparación API de la evaluación del flujo de Claude Code
Ambos experimentos son útiles. Una evaluación del flujo permite saber si el equipo termina mejor un trabajo en su entorno real. No separa cuánto de la diferencia procede del modelo, del ensamblado del contexto o de la orquestación. Si esos componentes también cambian entre ejecuciones, presente el resultado como comparación de configuraciones, sin atribuir toda la mejora a Fable 5.5.
Compare el coste por tarea aceptada
La tarifa por token es solo una parte del coste. Cuente los cargos de todos los intentos dentro del periodo evaluado, incluidos fallos, reintentos, herramientas y caché cuando corresponda. Divida después entre las tareas que cumplen los mismos criterios de aceptación:
Si no pasa ninguna tarea, no presente un coste finito por tarea aceptada. Indique cero tareas aceptadas y el gasto total. Registre el tiempo de revisión humana por separado, salvo que decida asignarle una tarifa monetaria y explique esa hipótesis.
| Registro de evaluación | Configuración A | Configuración B |
|---|---|---|
| Cargos de entrada sin caché, todos los intentos | 3 USD | 4 USD |
| Cargos de salida, todos los intentos | 5 USD | 6 USD |
| Cargos de lectura/escritura de caché, todos los intentos | 1 USD | 2 USD |
| Cargos adicionales de herramientas, todos los intentos | 3 USD | 3 USD |
| Cargos totales | 12 USD | 15 USD |
| Tareas aceptadas del mismo conjunto de 12 | 8 | 12 |
| Coste por tarea aceptada | 1,50 USD | 1,25 USD |
Asigne cada cargo una sola vez. Los intentos fallidos y los reintentos ya están incluidos en los totales de cada categoría; sumar otra línea de «coste de reintentos» los duplicaría. Concilie el desglose con la facturación real: los campos de uso de una ruta pueden incluir tokens en caché dentro del total de entrada. No aplique la tarifa sin caché a todo ese total y añada después los cargos de caché otra vez.
En este ejemplo, B cuesta más en total, pero menos por tarea aceptada. Aun así, podría ser inadecuada si supera un límite estricto de latencia o produce un error crítico. Separe las ejecuciones iniciales de las que reutilizan contexto para que la caché ya preparada no oculte el coste de la primera ejecución.
| Tokens de una petición | Opus 5.5 | Fable 5.1 | Proporción de coste Fable / Opus |
|---|---|---|---|
| 100 000 de entrada sin caché; sin lectura de caché; 2 000 de salida | $0.4400 | $1.1000 | 2.50× |
| 10 000 de entrada sin caché; 90 000 de lectura de caché; 2 000 de salida | $0.0980 | $0.2225 | 2.27× |
| 10 000 de entrada sin caché; 900 000 de lectura de caché; 2 000 de salida | $0.2600 | $0.4250 | 1.63× |
(10,000 × 4 + 90,000 × 0.20 + 2,000 × 20) / 1,000,000 = $0.098. Un historial largo con caché disponible reduce la proporción; no hace que Fable sea más barato ni incluye crear la caché. Los modelos reales pueden consumir cantidades distintas de tokens. Recalcule con sus peticiones y las tarifas aplicables de la ruta EvoLink, sin multiplicar la factura completa por 2.5.C el gasto medio total de API y herramientas por tarea enviada, incluidos reintentos, y p la proporción aceptada. El coste API por tarea aceptada es C / p. Un candidato cuyo multiplicador es r = C_candidate / C_Opus solo lo reduce si p_candidate > r × p_Opus. Con una referencia del 80% y un coste hipotético de 1.5× por tarea, necesitaría superar el 120% de aceptación: imposible según esta medida limitada al coste API. Aun así podría compensar si ahorra suficiente trabajo humano o evita fallos caros, pero esos beneficios requieren valoración propia. Por eso escalar tareas seleccionadas puede tener más sentido que sustituir todas las peticiones de Opus.¿Ahorra dinero utilizar Fable solo como advisor?
Compare tres configuraciones con las mismas tareas: el flujo actual de Opus, Opus con una combinación de advisor documentada y disponible, y —solo tras verificarlo— el candidato como modelo principal. Cuente el flujo completo en cada caso: llamadas al modelo principal, consultas al advisor, herramientas, reintentos y aceptación final.
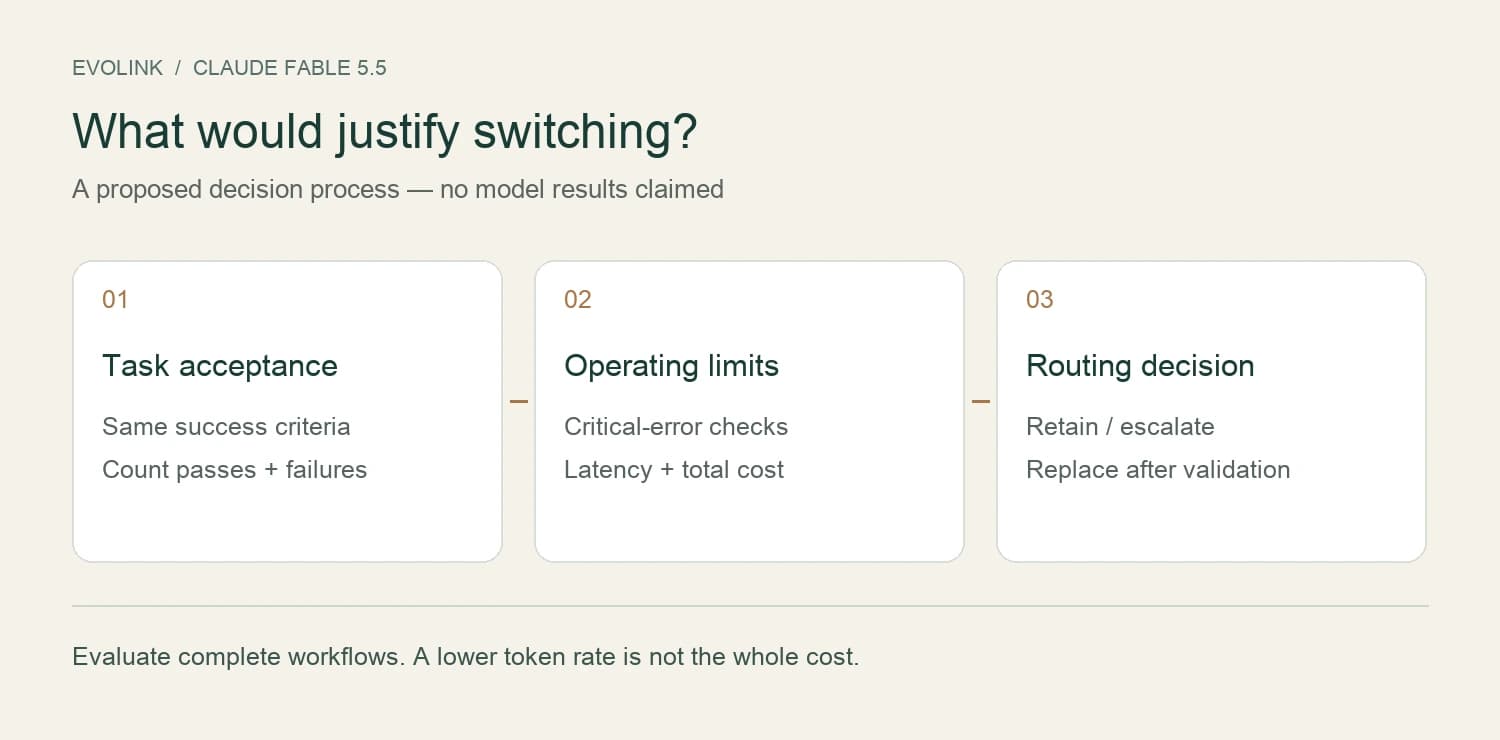
Decida entre mantener, derivar ciertas tareas o sustituir
Fije las reglas de aceptación antes de ver los resultados del candidato. Deben reflejar su aplicación: un error grave de herramienta puede impedir el despliegue aunque mejore la calidad media. Defina la latencia y el gasto máximos aceptables y quién resuelve las discrepancias sobre las respuestas.
- Mantenga Opus si cumple los requisitos y el candidato no ha demostrado una mejora útil.
- Derive solo ciertas tareas si un candidato verificado mejora un subconjunto difícil e identificable, pero añade coste o demora innecesarios al resto. Pruebe la propia regla de enrutamiento: los errores de clasificación pueden anular la ventaja.
- Sustituya el modelo predeterminado solo cuando se cumplan los requisitos de calidad, errores críticos, latencia y coste con tráfico representativo y una alternativa de respaldo probada.
La pasarela unificada de EvoLink puede mantener la selección de modelos en una superficie de integración común, pero eso no hace intercambiable su comportamiento. Compruebe el contrato de cada ruta. Deje el candidato sin configurar hasta verificar el acceso y revise un despliegue limitado antes de ampliar el tráfico.
Preguntas frecuentes
¿Es Fable 5.5 mejor que Opus 5.5?
Aquí no se aporta un resultado verificado de comparación directa. La identidad, el acceso y el comportamiento de Fable 5.5 siguen sin confirmar en las fuentes consultadas, por lo que no se puede establecer un ganador.
¿Debe seguir Opus 5.5 como modelo predeterminado?
Mantenga una configuración que cumpla sus requisitos hasta que una alternativa verificada supere su evaluación. La decisión depende de los resultados de las tareas, la latencia y el coste total.
¿Un nombre que sugiera mayor capacidad o una versión más nueva implica mejor programación?
No. Use tareas de repositorio con cambios esperados explícitos y pruebas de regresión. El nombre no demuestra que el modelo vaya a resolver su código.
¿Deben usar ambos modelos el mismo nivel de effort?
Solo si los ajustes documentados son realmente comparables. En caso contrario, registre cada configuración admitida y compare bajo las mismas restricciones operativas, explicando las diferencias.
¿Puedo decidir solo con los precios por token?
No. Reintentos, longitud de salida, herramientas, comportamiento de caché y tareas fallidas pueden cambiar el total. Compare los cargos reales por tarea aceptada con la misma definición de éxito.
¿Y si el candidato solo gana en tareas difíciles?
Considere derivarlas selectivamente después de verificar acceso y comportamiento. Incluya el coste y los errores de decidir qué peticiones se derivan.
¿Es una prueba de rendimiento de EvoLink?
No. Para este artículo no se realizó una llamada autenticada a Fable 5.5. La matriz de tareas, el protocolo y el ejemplo aritmético ayudan a evaluar; no son resultados medidos de modelos.
¿Dónde compruebo el estado de lanzamiento?
Fuentes y alcance
- Catálogo de modelos de Anthropic: orientación sobre modelos documentados y comprobación de identidad.
- Noticias de Anthropic: comprobación de pruebas de lanzamiento.
- EvoLink Opus 5.5: referencia actual de producto y precios.
- Documentación de advisor en Claude Code: contexto, uso adicional y comportamiento de caché; no demuestra compatibilidad con Fable 5.5.