Claude Fable 5.2: novedades de programación, razonamiento y agentes
Qué cambia en Fable 5.2: programación, razonamiento, demos de hardware y juegos, tarifas estándar un 20 % menores, esfuerzo y migración API.
 EvoLink TeamEquipo de producto
En este artículo
La cuestión práctica es si el modelo mantiene el avance de un proyecto largo: comprender código existente, dividir problemas, usar herramientas, comprobar resultados y cambiar de estrategia tras un error. Una respuesta más completa y un proyecto más fácil de entregar son resultados distintos. El segundo también depende de herramientas, tiempo de ejecución, revisiones humanas y factura final.
Qué lugar ocupa Fable 5.2 en la familia Claude
Fable está orientado a trabajos técnicos difíciles que requieren razonamiento sostenido. Anthropic recomienda comenzar la mayoría de las tareas con el último modelo Opus y pasar a Fable 5.2 cuando las evaluaciones sigan sin cumplir los requisitos con niveles de esfuerzo Opus más altos.
Para un cambio de estilo, un endpoint habitual o documentos organizados mediante reglas claras, un modelo que ya funciona puede seguir siendo la opción económica. Las dependencias complejas, las alternativas de diseño y las validaciones repetidas ofrecen más margen a un modelo potente. Una migración puede combinar estructuras de datos, comportamiento de negocio, despliegue y restricciones de rendimiento. Evitar una mala decisión y el trabajo de corregirla puede importar más que el precio de una solicitud.
Mythos 5.2 utiliza el mismo modelo subyacente. Fable incorpora protecciones de ciberseguridad y biología que permiten un acceso más amplio; Mythos se ofrece a organizaciones aprobadas mediante los programas de verificación de Anthropic. Los resultados de esos ámbitos deben conservar la atribución a su variante concreta.
Un contexto de 1 millón de tokens y una salida de 128K
claude-fable-5-2. Admite 1 millón de tokens de contexto, hasta 128K tokens de salida, entradas de texto e imágenes y salida de texto. El pensamiento adaptativo siempre está activo y el esfuerzo predeterminado de la API es high.Ese espacio permite aportar definiciones de interfaces, implementación, pruebas e historial de diseño para un repositorio, o varios informes y sus definiciones de datos para investigar. Sigue importando cómo se presenta el material. Una entrada útil establece:
- El entregable: código ejecutable, plan de migración o análisis completo.
- Las restricciones: compatibilidad de interfaces, coherencia de datos o latencia.
- Las comprobaciones disponibles: pruebas, verificación de tipos, compilaciones o scripts de validación.
- Las decisiones que puede tomar el modelo y las que debe resolver una persona.
Los objetivos claros y las comprobaciones ejecutables permiten reconocer el avance. El contexto aporta espacio; la estructura de la tarea determina cómo aprovecharlo.
Fable 5.2 mejora programación, razonamiento y lectura de gráficos
Los resultados publicados por Anthropic abarcan varias partes del trabajo técnico. El gráfico compara FrontierCode 2.0, FrontierSWE v2, Humanity's Last Exam con herramientas y Chartography sin herramientas.
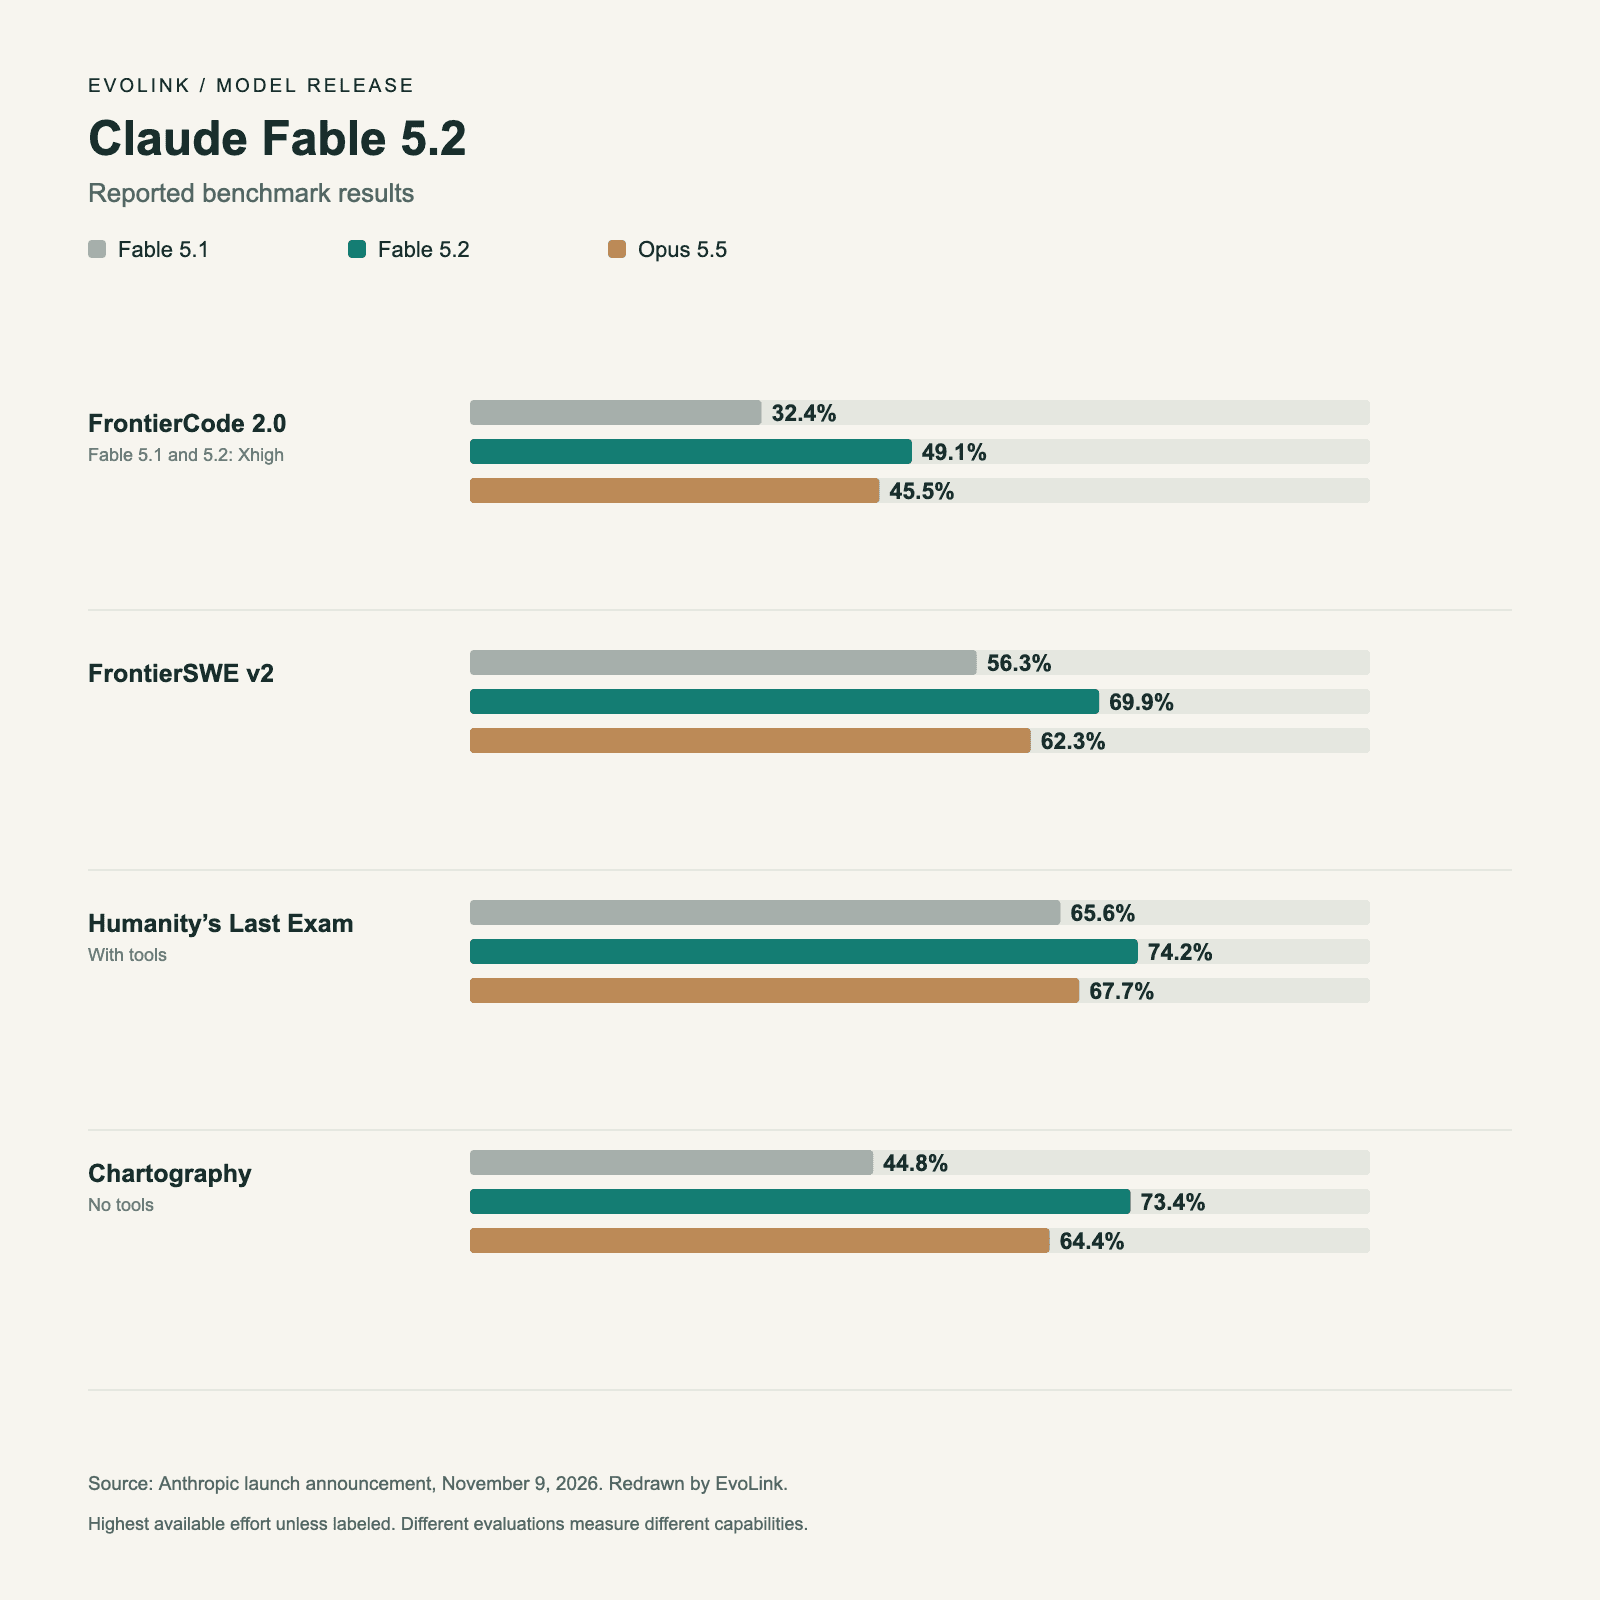
El código, el análisis de varios pasos y la extracción de datos visuales suelen coincidir. Un desarrollador puede aportar curvas de rendimiento y registros de errores para localizar un cuello de botella; un investigador puede leer un gráfico y comprobar una explicación mediante código; un equipo de producto puede convertir referencias visuales en una interfaz interactiva.
Evalúe con las entradas que usa su equipo. Si incluyen capturas de pantalla, gráficos y código, incorpore los tres. Un único prompt de texto puede ocultar diferencias importantes del flujo completo.
Prototipos electrónicos que conectan varias etapas de ingeniería
Anthropic y Diode encargaron a Fable 5.2 un altavoz de conferencias USB, un concentrador doméstico de asistente de voz y una mascota virtual portátil. El modelo trabajó en especificaciones, esquemas, colocación de componentes, trazado de PCB, carcasas y firmware. Los ingenieros de Diode fabricaron y probaron los dispositivos. Según Anthropic, los tres funcionaron sin corregir sus circuitos.
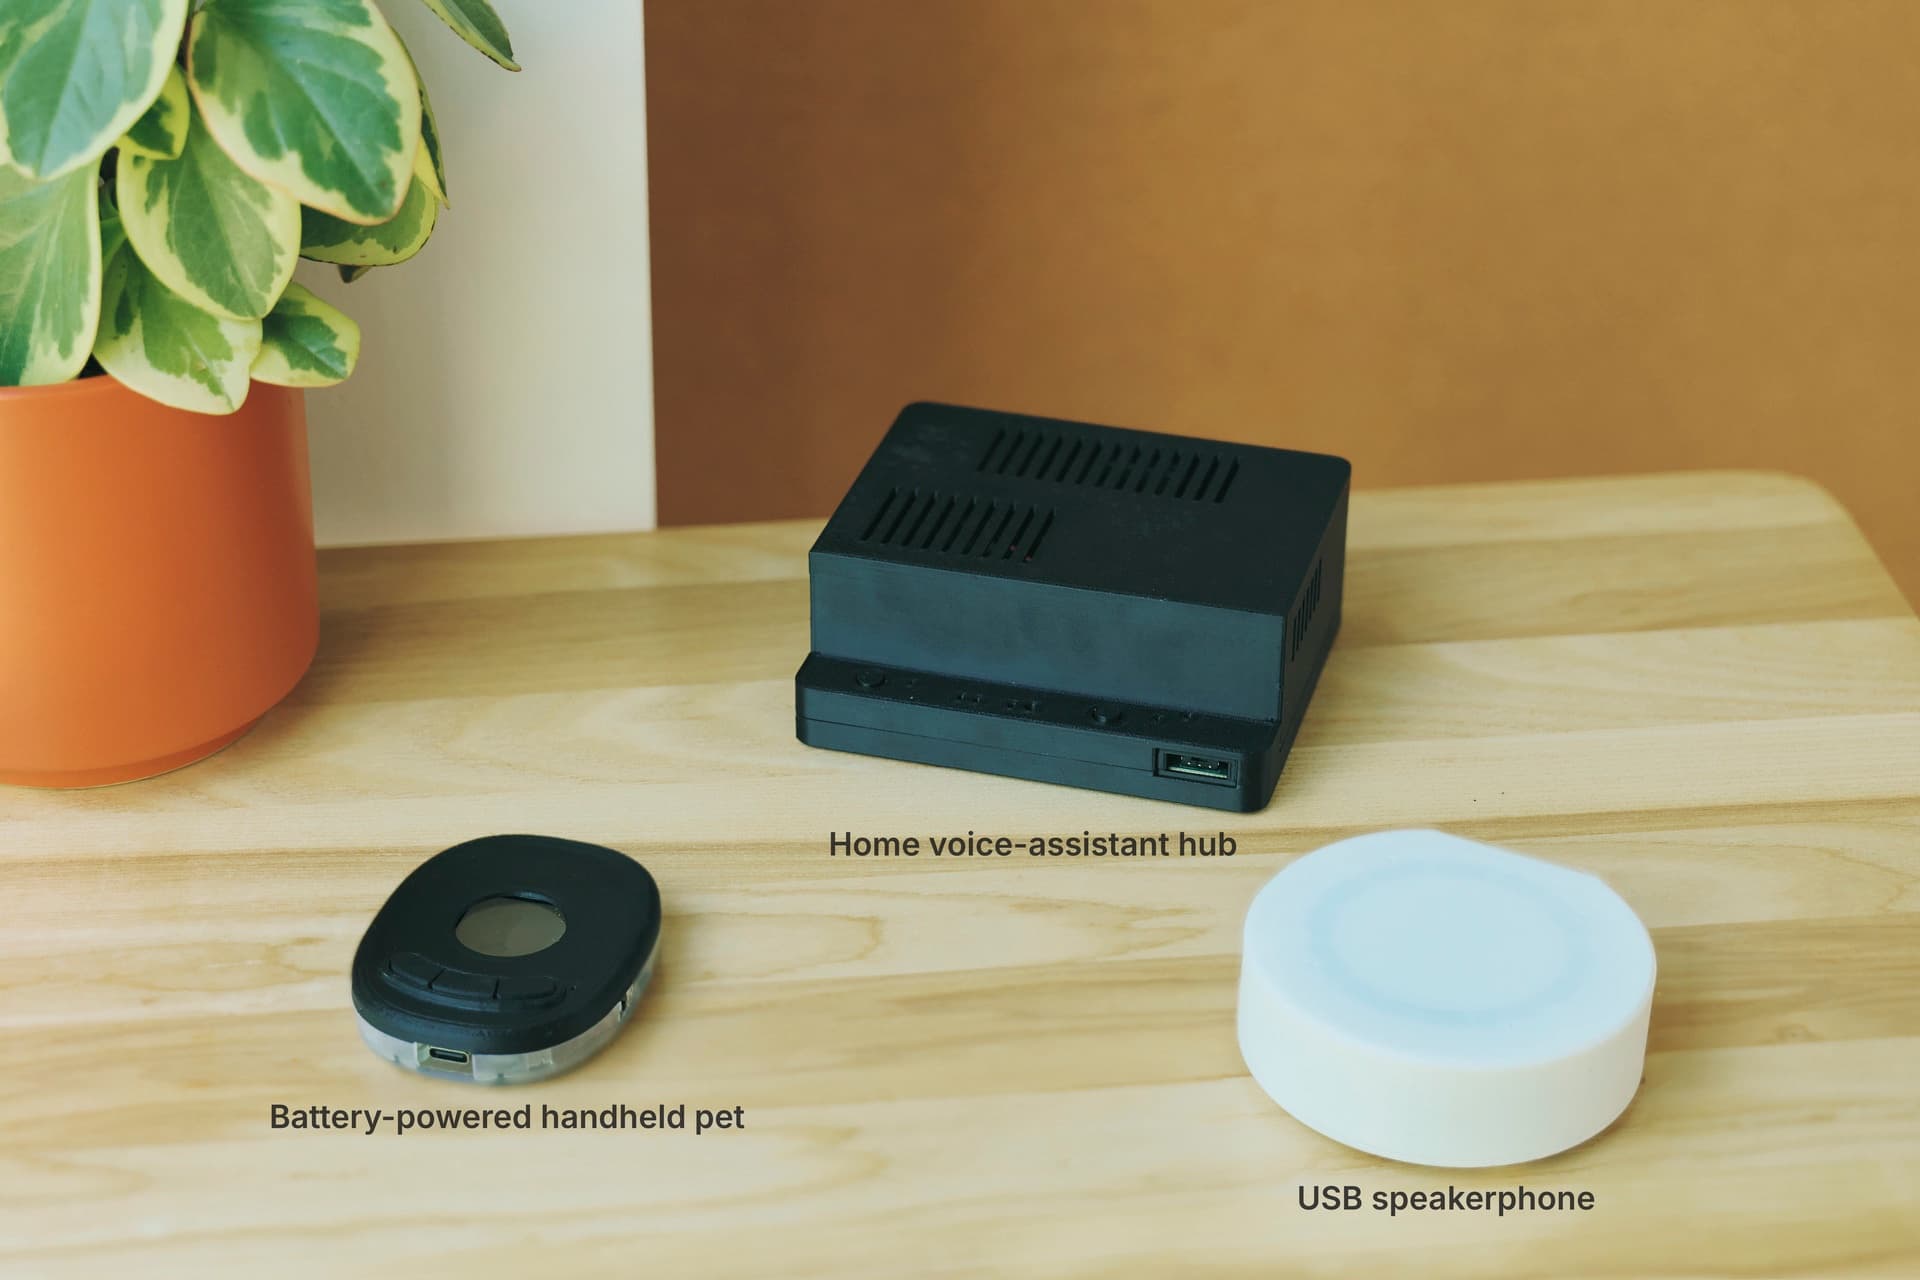
La colocación afecta al trazado, los conectores determinan aberturas de la carcasa y el montaje condiciona la mecánica. Una decisión razonable en una etapa puede provocar problemas después. El caso ilustra el valor de seguir restricciones y consecuencias durante todo el proyecto.
Siguen siendo prototipos: faltan validación eléctrica, ajuste de antenas, pruebas térmicas y certificación. Los diseños no están preparados para fabricación en serie. El logro es un prototipo funcional; la ingeniería de producto debe continuar. Los equipos de software pueden comprobar de forma parecida si el modelo consideró despliegue, monitorización, reversión y mantenimiento además de código ejecutable.
Un experimento con 1.000 agentes explora la colaboración prolongada
La cuestión para los sistemas de agentes es cómo asumen tareas dependientes, comparten avances, envían resultados y reúnen contribuciones. Un estado común y comprobaciones fiables permiten continuar. Una migración grande necesita interfaces compartidas, coordinación para evitar cambios duplicados y pruebas unificadas. Las subtareas de investigación necesitan definiciones de datos coherentes para combinar sus análisis.
Empiece por subtareas independientes y verificables antes de aumentar el número de agentes. La concurrencia añade costes de coordinación; los límites útiles entre tareas importan tanto como la cantidad de agentes.
Los juegos y las demos interactivas hacen visibles las capacidades
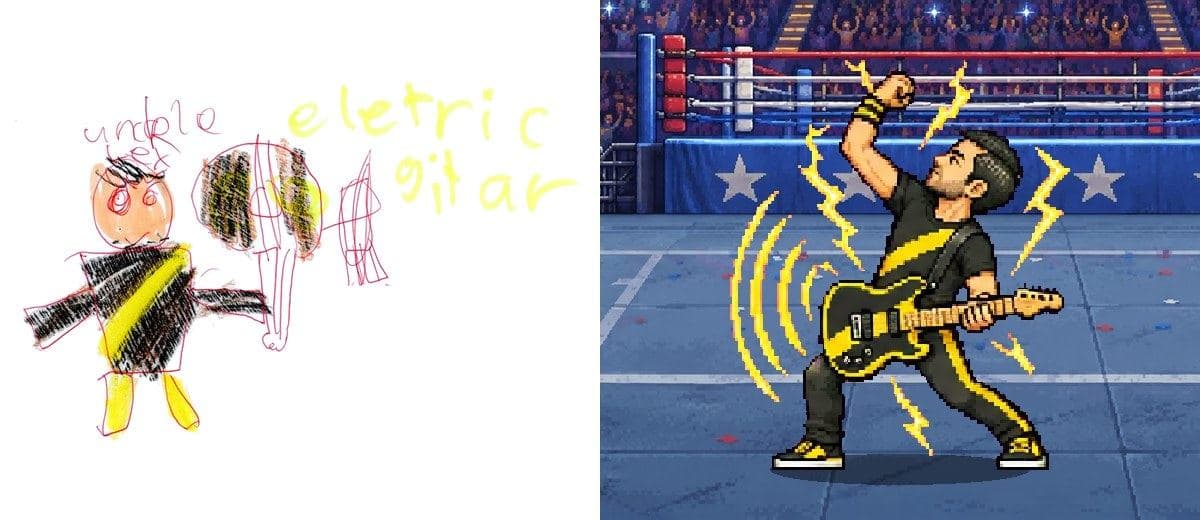
El interés está en una producción continuada: convertir personajes, historia y objetivo en código, llamadas a herramientas de recursos y pruebas. Los equipos de herramientas educativas, demostraciones interactivas o experiencias de marca podrían probar una explicación de producto con parámetros ajustables o una simulación manipulable para comprobar si la idea se entiende.
Evalúe respuesta de las interacciones, estabilidad y facilidad de modificación además del aspecto visual. Los prototipos cambian repetidamente; el código editable y unos recursos bien organizados influyen en el coste de las revisiones.
Tarifas estándar un 20 % menores y una opción de mayor velocidad
Las tarifas estándar publicadas por Anthropic son un 20 % inferiores a Fable 5.1:
| USD por millón de tokens | Fable 5.1 estándar | Fable 5.2 estándar | Fable 5.2 Fast mode |
|---|---|---|---|
| Entrada | $10 | $8 | $16 |
| Salida | $50 | $40 | $80 |
Fast mode puede servir cuando esperar tiene un coste, como en depuración interactiva. En tareas de fondo en cola, compruebe si el tiempo ahorrado justifica la tarifa superior.
La caché y la factura total siguen importando
Un agente puede reutilizar el contexto del proyecto y las definiciones de herramientas entre solicitudes. Si se cumplen las condiciones de caché, esos tokens se facturan de forma distinta a las entradas ordinarias. Las numerosas lecturas de caché del juego también explican por qué conviene separar categorías.
Registre entrada ordinaria, escritura y lectura de caché y salida por separado. Añada herramientas externas y correcciones humanas al evaluar el coste de un entregable aceptado. Las tarifas unitarias más bajas mejoran el cálculo inicial; la ejecución determina el ahorro final.
El esfuerzo también forma parte de la selección
low, medium, high, xhigh y max; la API usa high por defecto. Anthropic recomienda empezar en High, probar Xhigh después de medir beneficios en tareas difíciles y reservar Max para explorar límites o trabajos excepcionales donde tiempo y tokens sean secundarios.Resultados de Artificial Analysis consultados el 10 de noviembre de 2026:
| Configuración | Intelligence Index | Coste ponderado de evaluación por tarea |
|---|---|---|
| Medium | 56 | $3.80 |
| High | 62 | $9.08 |
| Max | 65 | $26.54 |
Las configuraciones llevan la etiqueta Default Fallback. Las tareas y costes corresponden a la metodología AA y no son presupuestos para tareas habituales. De High a Max mejora la puntuación en esta instantánea y aumenta considerablemente el gasto de evaluación.
Mantenga entradas, herramientas y criterios de aceptación constantes al variar el esfuerzo. Busque el primer nivel suficiente y compruebe si más presupuesto mejora el resultado real. Organizar información rutinaria y migrar dependencias complejas pueden justificar ajustes diferentes.
Revise los prompts antiguos al actualizar
La guía de Anthropic señala que las instrucciones permanentes para usar más subagentes pueden generar delegación innecesaria. Los presupuestos de tokens grandes escritos en el prompt también pueden afectar al consumo: eliminarlos redujo costes con resultados similares en algunas pruebas de código. La observación se refiere al presupuesto textual, no a la función task budgets de la API.
Revise si cada tarea necesita paralelismo, explorar todas las alternativas o reglas acumuladas y duplicadas. Unos criterios de finalización claros facilitan la evaluación. Conserve el prompt original y pruebe los cambios uno por uno según calidad, gasto y ejecución para distinguir efectos del modelo y del flujo de trabajo.
Qué comprobar antes de integrar en producción
Los canales oficiales incluyen Claude API, Amazon Bedrock, Google Cloud, Microsoft Foundry y Claude Platform on AWS. Los identificadores, funciones y facturación específicos deben comprobarse en la documentación de cada canal.
Hay cuatro cambios relevantes para integraciones existentes:
- Historial: modificar el prompt de sistema, las herramientas o los mensajes anteriores puede invalidar los bloques de pensamiento devueltos. La comprobación de prefijo se aplica a todas las cuentas; reenviar un bloque inválido sin definir
prefix_mismatch_behaviordevuelve un error 400. - Cambio de modelo: pasar de Fable 5.2 a Opus 5.5 en Claude API descarta los bloques de pensamiento de Fable, aunque la solicitud puede completarse.
- Computer use: la herramienta antigua
computer_20251124requiere migrar al nuevo conjunto, salvo en Amazon Bedrock. - Advisor: un ejecutor Fable 5.2 necesita un advisor compatible Fable 5.2 o Mythos 5.2.
Al gestionar modelos con una pasarela API unificada, compruebe transmisión de parámetros, facturación y tratamiento del historial al cambiar de modelo en conversaciones largas. Son comportamientos que afectan directamente a producción.
Qué equipos deberían evaluar primero Fable 5.2
Los usuarios de Fable 5.1 pueden retomar tareas con registros previos de calidad y coste para medir finalización, correcciones y gasto. Los equipos Opus pueden elegir dificultades recurrentes: código que sigue fallando tras varias correcciones o planes que incumplen restricciones interdependientes.
Los equipos de productos con agentes pueden evaluar Fable para planificación, análisis difícil y revisión crítica, asignando pasos de ejecución bien definidos a modelos más económicos. Mida traspasos de información y factura total antes de adoptar esa división.
Un punto de partida práctico reúne una tarea habitual, un problema difícil conocido y un proyecto largo. Compare calidad, duración, gasto total y cambios humanos para elegir modelo predeterminado, regla de escalado y esfuerzo. Fable 5.2 eleva el techo de capacidad y reduce tarifas estándar; las tareas conocidas muestran dónde se traduce en entregas fiables a un coste aceptable.
Preguntas frecuentes
¿Cuándo se lanzó Claude Fable 5.2 y qué cambia frente a 5.1?
¿El lanzamiento de Fable 5.2 justifica sustituir Opus 5.5?
¿Qué diferencia hay entre Fable 5.2 y Mythos 5.2?
¿Cómo afecta la rebaja del 20 % frente a Fable 5.1 al coste total de una tarea?
¿Puede Fable 5.2 generar imágenes o vídeos directamente?
¿Qué significan el contexto de 1 millón de tokens y la salida de 128K para tareas largas?
¿Qué canales de acceso se anuncian con Fable 5.2?
claude-fable-5-2. Los canales oficiales también incluyen Amazon Bedrock, Google Cloud, Microsoft Foundry y Claude Platform on AWS. Compruebe los identificadores, funciones y facturación específicos de cada canal. Para EvoLink, consulte la página Fable 5.2 con la integración y tarifas actuales; las rutas de terceros requieren comprobar también la compatibilidad de parámetros e historial. Disponibilidad oficial¿Con qué nivel de esfuerzo debería empezar?
high por defecto; admite low, medium, high, xhigh y max. Empiece en High y compare otros niveles con las mismas entradas, herramientas y criterios de aceptación. Pruebe Xhigh tras medir una mejora en tareas difíciles y use Max cuando explorar los límites justifique el tiempo y los tokens adicionales. Recomendaciones de esfuerzo¿Por qué una conversación existente puede devolver un error 400 tras actualizar?
prefix_mismatch_behavior devuelve 400. Revise el tratamiento del historial y el comportamiento documentado ante diferencias de prefijo. Otro caso distinto es cambiar de Fable 5.2 a Opus 5.5 en Claude API: puede descartar bloques de pensamiento aunque la solicitud tenga éxito. Cambios de migración